1  Біноміальний критерій

1.1 Генеральна сукупність та вибірка

Ви вирішили створити платформу онлайн-курсів з програмування. Ви записали навчальні відео та запропонували користувачам доступ за передплатою. Вартість курсу для студента становить 1000 гривень, а витрати на підтримку платформи та індивідуальні консультації коштують вам 500 гривень з кожного студента.

Проте ви помічаєте, що деякі люди відмовляються від курсу після першого заняття, якщо матеріал їм здається складним або нецікавим. Інвестори готові підтримати ваш проєкт, якщо рівень відмов буде нижче 50%.

Щоб це перевірити, ви проводите експеримент: залучаєте 30 нових студентів. 20 із них проходять курс й оплачують доступ, а 11 відмовляються. 20 — це більше половини, але чи достатньо цього, щоб довести перспективність проєкту?

Розв’язуючи таку задачу, ми припускаємо, що існує певна аудиторія, яка користуватиметься нашим сервісом. Цю групу називають генеральною сукупністю. Якщо запустити сервіс для всіх потенційних користувачів, у ньому буде певна частка успішних випадків, позначимо її як \(\mu\). Це невідомий параметр, який ми не можемо визначити безпосередньо. Натомість ми можемо проводити експерименти та досліджувати результати. Оскільки протестувати продукт на всій аудиторії неможливо, ми беремо вибірку з генеральної сукупності та аналізуємо частку успішних випадків.

Згідно з результатами нашого експерименту, спостережувана ймовірність оплати становить \(\hat{\mu} = 20/30 = 0.67\)1. Це означає, що 67% студентів оплатили доступ. Чи можемо ми зробити висновок, що справжня частка успішних випадків перевищує 50%?

Розгляньмо, чому отримане значення може не бути переконливим доказом. Припустимо, що ймовірність успішної оплати дорівнює \(\mu = 0.5\), і змоделюємо можливі результати для 30 студентів.

Давайте спростимо цю задачу до прикладу з підкиданням монетки та змоделюємо результати для 30 спроб:

  • Якщо монетка випаде орлом, студент оплачує доступ.
  • Якщо монетка випаде решкою, студент відмовляється від курсу.
  • Використаємо метод integers()2 до класу Generator, яка генерує випадкові цілі числа в заданому діапазоні.
  • Підкинемо монетку 30 разів та порахуємо кількість успішних випадків.


1rng = np.random.default_rng(seed=18)

2n = 30
3results = rng.integers(0, 1, size = 30, endpoint = True)
4success = np.sum(results) / n

5print(f"Кількість успішних випадків: {round(success, 3) * 100}%")
1
Ініціалізуємо генератор випадкових чисел з фіксованим seed.
2
Кількість студентів.
3
Генеруємо випадкові числа для кожного студента.
4
Обчислюємо частку успішних випадків.
5
Виводимо результат.
Кількість успішних випадків: 70.0%


Ми бачимо, що в експерименті частка успішних випадків навіть перевищила 63%, тоді як у симуляції була закладена ймовірність 50%.

Тому, на жаль, ми не можемо з абсолютною точністю визначити, яким є справжнє значення \(\mu\) у генеральній сукупності та чи перевищує воно 50%, незалежно від того, скільки спостережень ми проводимо. Однак, застосовуючи методи прикладної статистики, ми зможемо використати інструменти, які допоможуть ухвалити правильне рішення, зокрема й у цьому випадку.

1.2 Статистичні гіпотези

1.2.1 Постановка задачі

Ми з’ясували, що навіть за ймовірності \(\mu = 0.5\) можна отримати значну кількість успішних випадків. Насправді ми спеціально підбирали seed для отримання такого результату. Якщо повторити цей експеримент з іншим значенням seed або збільшити кількість спостережень, результат може виявитися іншим.

Порада

Спробуйте змінити seed (наприклад 22) або кількість спостережень та перевірте, як змінюється результат.

Тож велика кількість успішних випадків може бути результатом випадковості. Щоб вирішити, чи можна вважати результати експерименту статистично значущими необхідно отримати відповідь на питання:

Чи можна вважати, що спостережуване значення \(\hat{\mu}\) є більшим від \(\mu = 0.5\)?

Звернімося до теорії ймовірностей. Факт підписки на наш сервіс для кожного окремого студента можна розглядати як випадкову величину \(\xi\), яка підпорядковується розподілу Бернуллі3. Параметр цього розподілу, а саме ймовірність успіху, нам невідомий.

\[ \xi \sim \text{Bernoulli}(\mu) \]

де \(\mu\) — ймовірність успіху.

Нас цікавить підтвердження того, що \(\mu > 0.5\). У статистиці для перевірки гіпотез розглядають дві можливості (Neyman and Pearson (1933)):

  • Нульова гіпотеза (\(H_0\)) формулюється як твердження, яке ми прагнемо спростувати.
  • Альтернативна гіпотеза (\(H_1\)) висловлює припущення, яке ми хочемо довести.

Скорочено це записують як:

\[ \begin{aligned} H_0 &: \mu \leq 0.5 \\ H_1 &: \mu > 0.5 \end{aligned} \]

Зауважимо, що якщо в нашому експерименті з 30 студентами можна дивитися не на частку успіхів, а на їх кількість.

Тоді питання можна переформулювати так:

За умови вірності \(H_0\) наскільки ймовірно отримати 20 або більше успішних випадків з 30?

Якщо ми проводимо \(n\) незалежних спостережень, то сума цих випадкових величин також підпорядковується біноміальному розподілу4.

\[ S_n = \sum_{i=1}^{n} \xi_i \sim \text{Binomial}(n, \mu) \]

де \(\xi_i\) — випадкова величина, яка показує успіх у \(i\)-му спостереженні, \(S_n\) — кількість успішних випадків у \(n\) спостереженнях, \(n\) — кількість спостережень, \(\mu\) — ймовірність успіху.

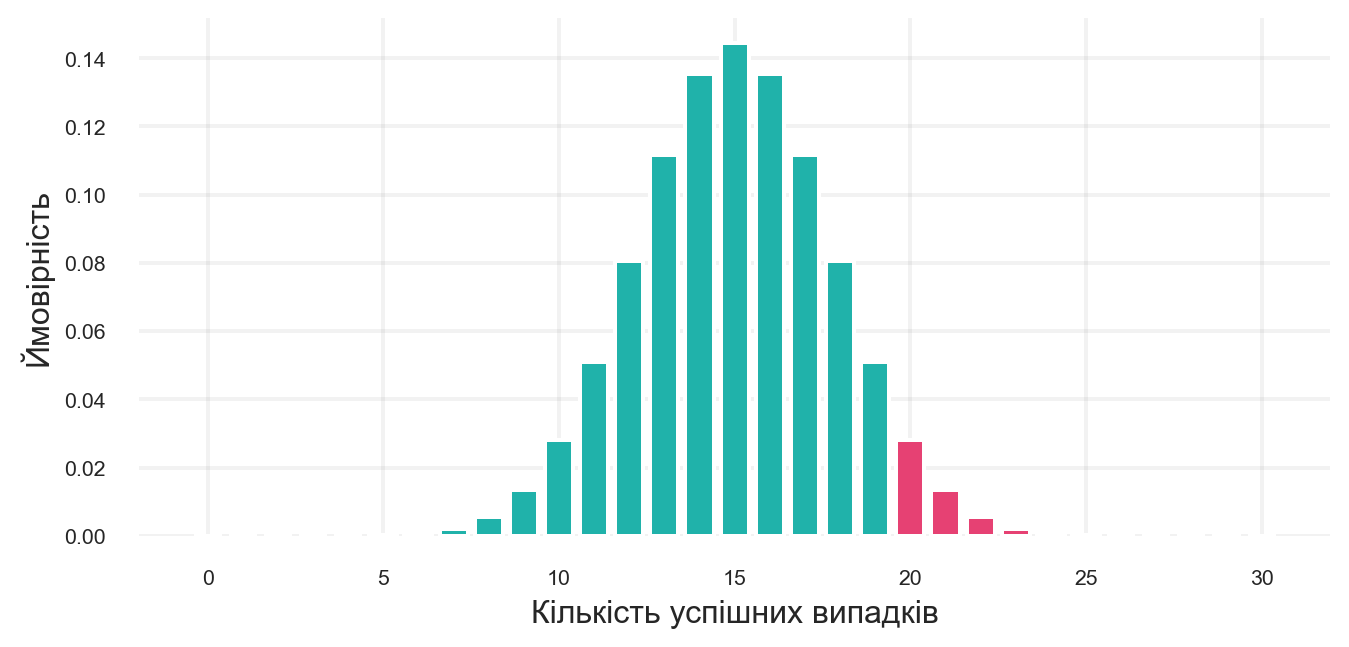
Давайте подивимось, як це виглядає графічно. Для цього побудуємо графік функції щільності ймовірностей для біноміального розподілу з параметрами \(n = 30\) та \(\mu = 0.5\).


1n = 30
2mu = 0.5

3x = np.arange(0, n + 1)
4y = binom.pmf(x, n, mu)

5plt.bar(x, y, color=turquoise)
6plt.bar(x[x >= 20], y[x >= 20], color=red_pink)
plt.xlabel("Кількість успішних випадків")
plt.ylabel("Ймовірність")
plt.show()
1
Кількість студентів.
2
Ймовірність успіху.
3
Створюємо масив з усіма можливими значеннями кількості успішних випадків.
4
Обчислюємо ймовірності для кожної кількості успішних випадків.
5
Створюємо гістограму з ймовірностями.
6
Виділяємо ймовірності для кількості успішних випадків, які є більшими або рівними 20.
Рисунок 1.1: Візуалізація функції щільності ймовірностей для біноміального розподілу

Ціановим5 кольором позначено ймовірності для кожної кількості успішних випадків. Рожевими виділено ймовірності для кількості успішних випадків, яка перевищує або дорівнює 20.

1.2.2 Критерій

Щойно ми розробили алгоритм, який на основі вибірки \(\xi\) або визнає наявність доказів на користь \(H_1\), або повідомляє, що таких доказів немає. Відповідно, він або відхиляє \(H_0\), або не відхиляє її.

Такий алгоритм називається критерієм. Його можна подати у вигляді функції \(S\), яка приймає реалізацію вибірки та повертає \(1\), якщо слід відхилити \(H_0\), та \(0\) в іншому випадку.

\[ S(\xi) = \begin{cases} 1, \text{ якщо відхиляємо } H_0 \\ 0, \text{ в іншому випадку} \end{cases} \]

Давайте припустимо, що ми вирішили відхилити \(H_0\), якщо кількість успішних випадків перевищує або дорівнює 21. Тоді критерій набуде вигляду:

\[ S(\xi) = \begin{cases} 1, \text{ якщо } \sum \xi_i \geqslant 21 \\ 0, \text{ в іншому випадку} \end{cases} \]

Зазвичай скорочують запис і пишуть просто правило, за яким відхиляємо \(H_0\)

\[ S = \{\sum \xi_i \geqslant 21\} \]

Позначимо \(Q = \sum \xi_i\), \(C = 21\), тоді критерій набуває вигляду:

\[ S = \{Q(\xi) \geqslant C\} \tag{1.1}\]

Так влаштована більшість класичних критеріїв у прикладній статистиці, тому величинам у ньому дано спеціальні назви. \(Q\) називається статистикою критерію, \(C\) — критичним значенням.

\(Q\) може бути будь-якою функцією від вибірки, яку ви вважаєте логічною для перевірки гіпотези. У нашому випадку це кількість успіхів, або сума всіх \(\xi_i\). Але ви можете вибрати й інші: максимальне значення, суму перших 5 значень або навіть просто перший елемент.

1.2.3 Критична область

Знову перепишемо наше основне запитання, тільки тепер з використанням нашого критерію \(S\):

Наскільки часто може бути таке, що за справедливості \(H_0\) критерій \(S\) відхиляє гіпотезу?

Відповідь на це запитання залежить від критичного значення. Зараз ми взяли його рівним 21, побачивши на рисунку 1.1, що великі відхилення відбуваються при \(H_0\) рідко. Але що означає рідко й наскільки рідко, не сказали. Тепер наша мета зрозуміти, як вибрати критичне значення \(C\), виходячи з частоти помилок нашого критерію.

Вибираючи \(C\), ми можемо або часто відхиляти нульову гіпотезу, коли \(C\) мале, або можемо робити це рідше, коли \(C\) велике. Щоб вибрати правильне значення, потрібно визначитися, коли наш критерій помиляється.

  • \(C = 16\). Якщо відхиляти гіпотезу при отриманні хоча б 16 успішних підписок із 30, то це навряд чи влаштує інвесторів. Так, успіхів більше половини. Але якщо в генеральній сукупності ймовірність 0.5, то майже в половині випадків ми будемо відхиляти гіпотезу. Критерій помилково повертає \(1\), тобто це помилка хибно позитивна (false positive, FP).

  • \(C = 29\). У такому разі будемо відхиляти гіпотезу тільки за 29 або 30 успіхів. Ці значення, звісно, говорять про те, що відхилення від 50% успіхів сильне. Але якщо в генеральній сукупності ймовірність, наприклад, 60%, то такі значення будуть виходити рідко. Але ж такі ймовірності теж влаштували б інвесторів, й ми б змогли відкрити стартап! А з таким критерієм ми навряд чи доб’ємося цього. Не відхилити гіпотезу \(H_0\), коли вона неправильна — це теж помилка. Вона називається хибно негативна (false negative, FN), оскільки критерій повернув 0 помилково.

\[ \text{FP} - H_0 \text{відхиляється, коли вона вірна} \]

\[ \text{FN} - H_0 \text{не відхиляється, коли вона не вірна} \]

У нашому завданні інвесторам важливіше хибно позитивна помилка. Їм дуже не хочеться потрапити в ситуацію, коли їм показали доказ успішності бізнесу, а виявилося, більшість користувачів відмовляється оформлювати підписку й компанія не отримує прибуток. Це призведе до збитків. Хибно негативна помилка призведе до того, що ви втратите успішний бізнес, але інвестори грошей не втратять.

Тому виберемо поріг, щоб ймовірність хибно позитивної помилки була задовільною, або ж частота хибнопозитивних спрацьовувань (False Positive Rate, FPR). Для цього треба зрозуміти, як часто ми будемо відхиляти гіпотезу, за умови вірності \(H_0\).

Тепер знову переформулюємо основне питання, повністю з використанням нових термінів, й врешті-решт відповімо на нього.

Який FPR у критерію \(S\) для перевірки гіпотези \(H_0\) проти \(H_1\)?

Коли \(H_0\) є вірною, щоб порахувати кількість успіхів ми проводили 30 разів підкидання монетки з ймовірністю орла \(0.5\). Кількість орлів (тобто успіхів) у такому експерименті має розподіл, який називається біноміальним, тобто при \(\mu = 0.5\) наша статистика має біноміальний розподіл \(Q \sim Binom(0.5, 30)\).

Обчислимо FPR для \(C = 21\)

\[ \begin{aligned} FPR &= P(S(\xi) = 1\ |\ H_0) \\ &= P(Q \geqslant 21\ |\ H_0) \\ &= P(Q \geqslant 21\ |\ \mu = 0.5) = \\ &= P(Q \geqslant 21\ |\ Q \sim Binom(0.5, 30)) \end{aligned} \]

Це вже ймовірність події за конкретного розподілу випадкової величини. Його можна подивитися за таблицею або, що зручніше, обчислити з використанням мов програмування.

1.2.4 Обчислення FPR

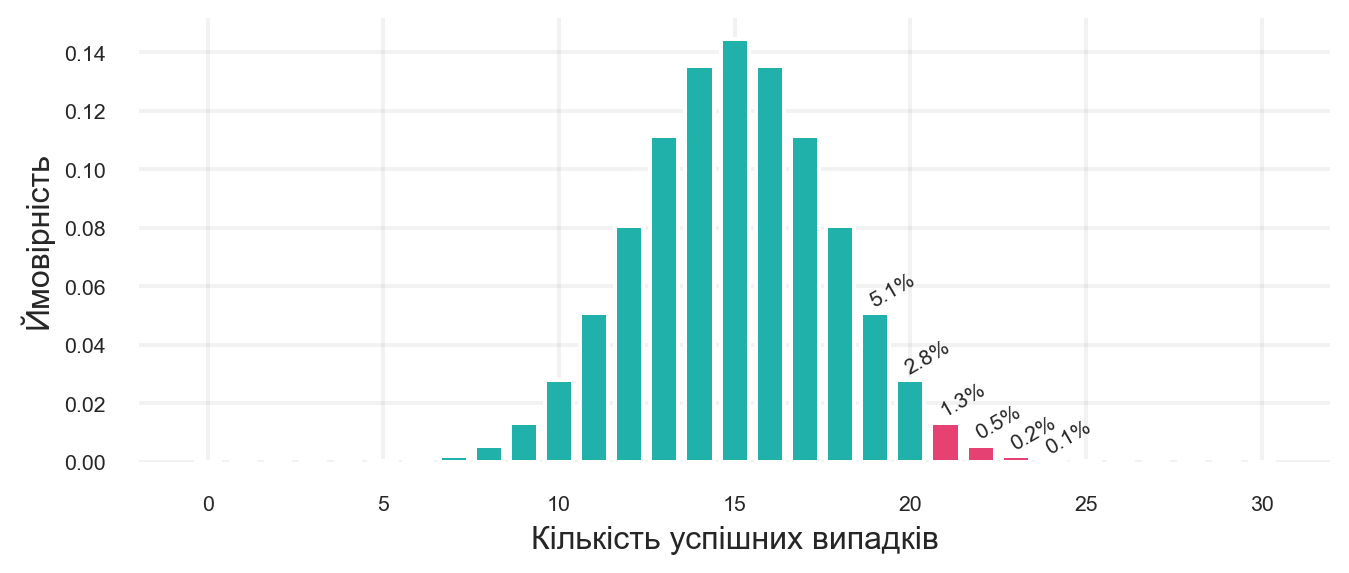
Давайте порахуємо суму ймовірностей для кількостей успіхів від 21 до 30 включно. Покажемо графічно, як це виглядає на Рисунку 1.2.


1x = np.arange(0, n + 1)
2y = binom.pmf(x, n, 0.5)

fig, ax = plt.subplots(figsize=(8, 3))
3plt.bar(x, y, color=turquoise)
4plt.bar(x[x >= crit_subs], y[x >= crit_subs], color=red_pink)
5for i in range(crit_subs - 2, crit_subs + 4):
    plt.text(i + 0.5, y[i] + 0.001, f"{round(y[i] * 100, 1)}%",
    ha='center', va='bottom', size=8, rotation = 30)
plt.xlabel("Кількість успішних випадків")
plt.ylabel("Ймовірність")
plt.show()
1
Створюємо масив з усіма можливими значеннями кількості успішних випадків.
2
Обчислюємо ймовірності для кожної кількості успішних випадків.
3
Створюємо гістограму з ймовірностями.
4
Виділяємо ймовірності для кількості успішних випадків, яка є більшою або рівною 21.
5
Додаємо текст до гістограми.
Рисунок 1.2: Ймовірність хибно відхилити \(H_0\) за умови її вірності

Залишається лише обчислити суму ймовірностей для кількостей успіхів від 21 до 30 включно. Це і буде нашим FPR.

\[ FPR_{21} = \sum_{i = 21}^{30} P(Q = i) \approx 0.021 \]

У нашому випадку це буде 2.1%. Якщо FPR не перевищує деякої константи \(\alpha\), то критерій називається критерієм рівня значущості \(\alpha\). Статистичний критерій з \(\alpha\) = 100% створити тривіально — достатньо завжди відхиляти \(H_0\) — тому така постановка не має сенсу.

Рівень значущості зазвичай обирають на основі бізнес-міркувань. Він позначає те, який ризик неправильного прийняття позитивного рішення ми вважаємо прийнятним. Зазвичай беруть \(\alpha = 0.05\), але якщо потрібне більш точне ухвалення рішення, можуть вибрати \(0.01\), \(0.005\), \(0.001\). Якщо ж рішення не таке критичне, можуть вибрати \(0.1\).

Припустимо, вибрали значення \(\alpha = 0.05\), скористаємося критерієм \(S\): тобто якщо кількість успішних випадків перевищує або дорівнює 21, то відхиляємо \(H_0\).

Якщо уважно подивитись на Рисунок 1.2, то можна помітити, що ми можемо відхиляти \(H_0\) при кількості успіхів від 20, а не 21, оскільки такий все ще буде відповідати \(\alpha = 0.05\):

\[ FPR_{20} = \sum_{i = 20}^{30} P(Q = i) \approx 0.049 \]

Якщо ж обрати 19, то FPR буде більше \(\alpha\): \[ FPR_{19} = \sum_{i = 20}^{30} P(Q = i) \approx 0.1002 \]

1.3 Статистичні функції в Python

У цій частині подивимося, як вивести те, що ми отримали в частині 2, за допомогою Python. А також зрозуміємо, як знайти відповідне \(C\) за допомогою Python.

1.3.1 Біноміальний розподіл

Ми з’ясували, що статистика \(Q\) має біноміальний розподіл.

Біноміальний розподіл \(Binom(n, \mu)\) — розподіл кількості успіхів у послідовності з \(n\) незалежних випадкових експериментів, ймовірність успіху в кожному з яких дорівнює \(\mu\).

Щоб працювати з розподілом, можна створити об’єкт-розподіл за допомогою бібліотеки scipy.stats (SciPy community (2023)).


from scipy.stats import binom

1n = 30
2mu = 0.5

3binom_dist = binom(n, mu)
1
Кількість спостережень.
2
Ймовірність успіху.
3
Створюємо об’єкт біноміального розподілу.

1.3.2 Функція ймовірностей

Функція ймовірності дискретного розподілу \(p_\xi(x)\) — ймовірність, з якою \(\xi\) приймає значення \(x\).

У Python це функція pmf (probability mass function).


result = binom_dist.pmf(20)
print(f"Ймовірність отримати 20 успішних випадків: {result:.4f}")
Ймовірність отримати 20 успішних випадків: 0.0280


Зобразимо розподіл статистики \(Q\) за справедливості \(H_0\) на графіку. Для цього можна передати відразу масив точок, для яких треба розрахувати ймовірність.


1x = np.arange(0, n + 1)
2y = binom_dist.pmf(x)

3crit_subs = 21

fig, ax = plt.subplots(figsize=(8, 2.5))
4plt.bar(x, y, color=turquoise, label="Ймовірність успіхів")
5plt.bar(x[x >= crit_subs], y[x >= crit_subs],
        color=red_pink, label="Критичне значення")
plt.xlabel("Кількість успішних випадків")
plt.ylabel("Ймовірність")
plt.show()
1
Масив точок.
2
Розрахунок ймовірностей.
3
Критичне значення.
4
Ймовірність успіхів.
5
Критичне значення.
Рисунок 1.3: Функція щільності ймовірностей біноміального розподілу

Насправді вже зараз ми можемо порахувати ймовірність потрапляння в критичну область. Потрібно просто підсумувати ймовірності для кількостей успіхів від 21 до 30.


result = np.sum(y[crit_subs:])
print(f"Ймовірність потрапляння в критичну область: {result:.4f}")
Ймовірність потрапляння в критичну область: 0.0214


Отже, ми дійсно побудували критерій рівня значущості \(\alpha = 0.05\). Ба більше, це критерій рівня значущості 0.021.

А що якби ми взяли \(C = 19\)?


crit_subs = 19
result = np.sum(y[crit_subs:])
print(f"Ймовірність потрапляння в критичну область: {result:.4f}")
Ймовірність потрапляння в критичну область: 0.1002


Тоді ймовірність помилки вже навіть більше \(10\%\), що зовсім нам не підходить.

А якщо \(C = 20\)?


crit_subs = 20
result = np.sum(y[crit_subs:])
print(f"Ймовірність потрапляння в критичну область: {result:.4f}")
Ймовірність потрапляння в критичну область: 0.0494


Видно, що немає такого \(C\), щоб FPR був рівно \(5\%\).

1.3.3 Кумулятивна функція розподілу

Кумулятивна функція розподілу задається формулою:

\[ F_\xi(x) = P(\xi \leqslant x) \tag{1.2}\]

У Python це метод cdf() (Cumulative Distribution Function).


result = binom_dist.cdf(19)
print(f"Ймовірність отримати 19 або менше успішних випадків: {result:.4f}")
Ймовірність отримати 19 або менше успішних випадків: 0.9506


А оскільки \(P(\xi \leqslant 19) + P(\xi \geqslant 20) = 1\), можемо обчислити рівень значущості нашого критерію.


result = 1 - binom_dist.cdf(19)
print(f"Ймовірність потрапляння в критичну область: {result:.4f}")
Ймовірність потрапляння в критичну область: 0.0494


1.3.4 Квантиль

Щоб вибрати критичну область для критерію, ми хотіли б знайти точку, площа стовпців праворуч від якої була б \(5\%\). Тобто площа стовпців зліва — \(95\%\). Така точка називається квантилью.

\[ u_p(\xi) = \{x\ | F_\xi(x) = p\} \tag{1.3}\]

Але при \(p = 0.95\) й нашому біноміальному розподілі, такої точки немає. Ми з’ясували, що є точка, праворуч від якої площа \(0.494\), а в наступної вже \(0.1\). Щоб визначити квантиль у цьому випадку, модифікуємо визначення. Квантиль \(u_p(\xi)\) — величина, яку \(\xi\) не перевищує з імовірністю хоча б \(p\). Тобто \(F_\xi(u_p) \geqslant p\).

\[ u_p(\xi) = min\ \{x\ |\ F_\xi(x) \geqslant p \} \tag{1.4}\]

Приклад 1.1 Для величини \(\xi \sim Bin(30, 0.5)\) порахуємо 0.95-квантиль. Вирішимо задачу просто підбором.

\[ P(\xi \leqslant 18) \approx 0.90 \]

\[ P(\xi \leqslant 19) \approx 0.951 \]

\[ P(\xi \leqslant 20) \approx 0.97 \]

Бачимо, що 18 нам ще не підходить, а 19 й більші значення вже підійдуть. У них функція розподілу буде більшою за \(p\). Відповідь — найменше відповідне значення, тобто 19. При цьому немає точки, де функція розподілу дорівнювала б \(p\) в точності.

Якби розподіл був неперервним, можна було б сказати, що квантиль — це таке \(x\), на якому функція розподілу дорівнює \(p\). Але для дискретного розподілу такого може не бути.

У Python квантиль можна порахувати через методу ppf() (Percent Point Function).


result = binom_dist.ppf(0.95)
print(f"0.95-квантиль: {result}")
0.95-квантиль: 19.0


Як тепер підібрати \(C\) для будь-яких \(n, \mu\) й для будь-якого рівня значущості \(\alpha\)?

  1. Потрібно знайти \(C\), таке що \(P(Q \geqslant C) \leqslant \alpha\)
  2. Тобто потрібно \(P(Q < C) \geqslant 1 - \alpha\)
  3. \(Q\) приймає тільки цілі значення: \(P(Q \leqslant C - 1) \geqslant 1 - \alpha\), або \(F(C - 1) \geqslant 1 - \alpha\)
  4. Отже, з визначення квантилі, \(C - 1 = u_{1 - \alpha}\)
  5. Значить \(C = u_{1 - \alpha} + 1\)


1def find_crit_subs(n, mu, alpha):
    """
    Знаходить критичне значення для біноміального розподілу.

    n: кількість спостережень
    mu: ймовірність успіху
    alpha: рівень значущості
    """
2    binom_dist = binom(n, mu)
3    return binom_dist.ppf(1 - alpha) + 1


result = find_crit_subs(30, 0.5, 0.05)
print(f"Критичне значення для n = 30, mu = 0.5, alpha = 0.05: {result}")
1
Функція, що приймає кількість спостережень, ймовірність успіху та рівень значущості.
2
Створюємо об’єкт біноміального розподілу.
3
Повертаємо критичне значення.
Критичне значення для n = 30, mu = 0.5, alpha = 0.05: 20.0


Критичне значення \(20\), отже підсумковий критерій має такий вигляд:

\[ S = \{Q \geqslant 20\} \]

\(Q = 19\), значить гіпотезу ми не відкидаємо.

При цьому нам вдалося побудувати процес, за яким ми ухвалюємо рішення для будь-якого рівня значущості та значення статистики критерію.

1.4 \(p\)-значення

Зауважимо, що зараз, якщо нам зададуть іншу \(\alpha\), нам доведеться перебудовувати критерій заново. Це не зовсім зручно. У статистиці є механізм \(p\)-значення, який дає змогу прийняти рішення для всіх \(\alpha\) відразу.

1.4.1 Більш екстремальні значення

Припустимо, ми провели експеримент й порахували для критерію його статистику \(Q(\xi)\). Позначимо отримане значення \(q\), у поточній задачі це \(q = 19\). Якби кількість успішних підписок була більшою, це б сильніше свідчило на користь альтернативної гіпотези \(H_1\). Тобто в разі значення \(25\) ми були б ще сильніше впевнені в тому, що наш бізнес буде окупатися. Тоді значення \(25\) називається більш екстремальним, ніж значення \(19\). У нашій задачі більш екстремальним із двох значень є те, яке більше.

Визначимо поняття екстремальності формально:

\[ S = \{Q(\xi) \geqslant C\}:\ t\ \text{екстремальніше}\ q \Leftrightarrow t > q \tag{1.5}\]

Найчастіше критерії інших видів можна привести до цього, тоді для них теж визначено поняття екстремальності.

1.4.2 \(p\)-значення

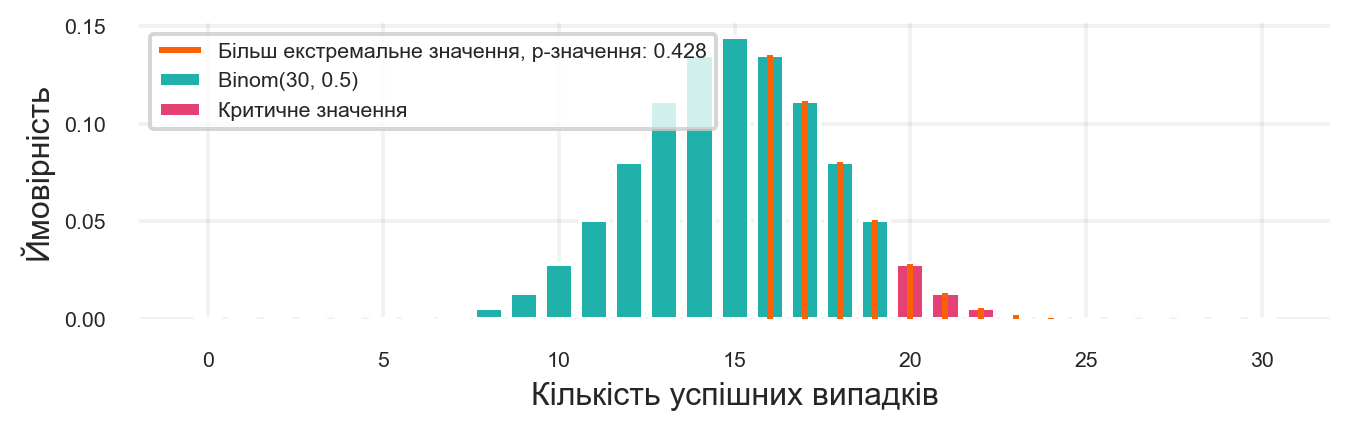
p-value — це ймовірність отримати таке або більш екстремальне значення статистики \(q\) за умови вірності \(H_0\) (Wasserman (2004)).

\[ P_{H_0}(Q \geqslant q) \tag{1.6}\]

Рисунок 1.4: \(p\)-значення для критерію \(Q = 15\)

Тепер виведемо формулу через функції Python:

\[ P_{H_0}(Q \geqslant q) = 1 - P_{H_0}(Q < q) = 1 - F(q) \tag{1.7}\]

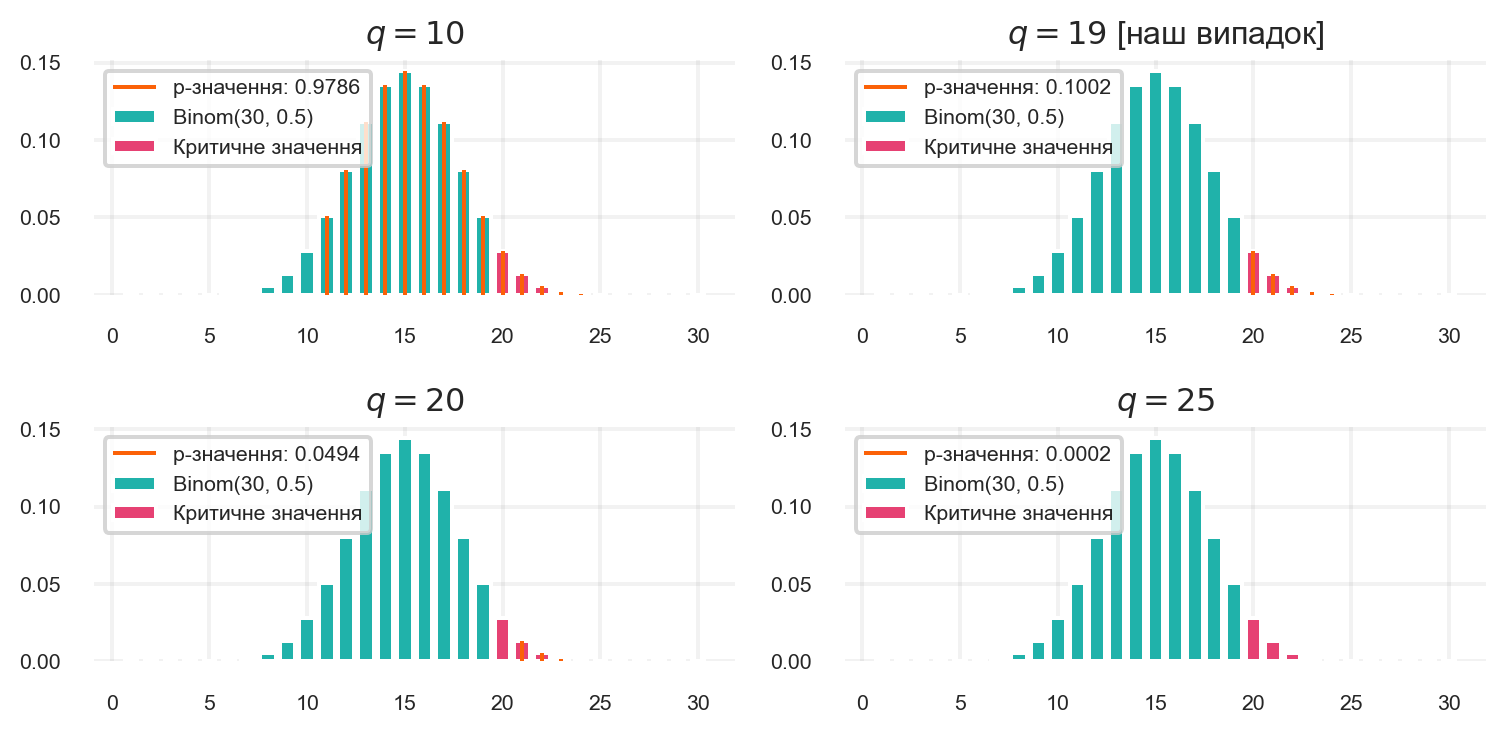
Зобразимо на графіку область більш екстремальних значень й p-value для різних значень статистики.

Рисунок 1.5: \(p\)-значення для критерію \(Q = 10, 19, 20, 25\)

Можна побачити, що в критичній області \(p\)-значення \(\leqslant \alpha\), а поза нею \(p\)-значення \(> \alpha\). Саме таке правило й використовується для прийняття рішення.

\[ H_0 \text{ відкидається } \Leftrightarrow p\text{-значення} \leqslant \alpha \tag{1.8}\]

Причому за \(p\)-значення одразу видно, що якби в нашу критичну область включили значення \(19\), наш критерій допускав би FPR у \(10\%\) випадків, що вже неприпустимо. Тому й гіпотезу ми не відкидаємо.

Зауважимо, що для обчислення \(p\)-значення не знадобилося знання \(\alpha\), а потрібна була тільки статистика й форма критерію.

1.5 Двосторонні критерії

До цього моменту нас цікавили відхилення від ймовірності в \(50\%\) тільки в один бік. І логічно, адже це продиктовано бізнесом. Тільки велика частка успішних підписок призведе до успіху. І зазвичай при прийнятті рішень так й буває. При тестуванні нового рішення або продукту розглядають альтернативну гіпотезу тільки в бік поліпшення, тому що в іншому разі немає сенсу впроваджувати рішення на всіх користувачів.

Однак іноді може знадобитися доводити відхилення в обидва боки, якщо ви перевіряєте якесь припущення. Нехай вам дали монетку й просять перевірити, чесна вона чи ні. Монетка чесна, якщо під час підкидання ймовірність випадання орла дорівнює \(0.5\). Ви підкидаєте монетку \(30\) разів, кожен кидок — бернуллівська величина, аналогічно завданню з сервісом освітніх послуг. Нульова гіпотеза та ж сама: \(\mu = 0.5\). Але тепер ми хочемо відкидати цю гіпотезу як у разі великої ймовірності орла, так і в разі маленької, відповідно перевіряємо двосторонню гіпотезу.

\[ H_0: \mu = 0.5 \]

\[ H_1: \mu \neq 0.5 \]

Виберемо критичну область для критерію за такої альтернативи. Скористаємося тією ж статистикою \(Q(\xi) = \sum \xi_i\). Тільки тепер відхилення в кожну сторону однаково важливі. Відкидати гіпотезу будемо не тільки на досить великих значеннях, а й на досить маленьких. Наприклад, якщо у нас було всього \(2\) орла з \(30\) — це свідчення на користь того, що \(\mu \neq 0.5\), але не на користь \(\mu > 0.5\).

Оскільки відхилення в різні боки однаково важливі, а розподіл симетричний, шукати критерій можна в такому вигляді:

\[ S = \{Q \geqslant C\} \cup \{Q \leqslant n - C\} \tag{1.9}\]

1.5.1 Як вибрати критичну область

Для двостороннього критерію потрібно вибрати таку область, щоб ймовірність потрапляння в неї була \(\alpha\). Тобто

\[ P_{H_0}(Q \geqslant C) + P_{H_0}(Q \leqslant n - C) = \alpha \tag{1.10}\] Але оскільки розподіл симетричний, то \[ P_{H_0}(Q \geqslant C) = P_{H_0}(Q \leqslant n - C) = \frac{\alpha}{2} \tag{1.11}\]

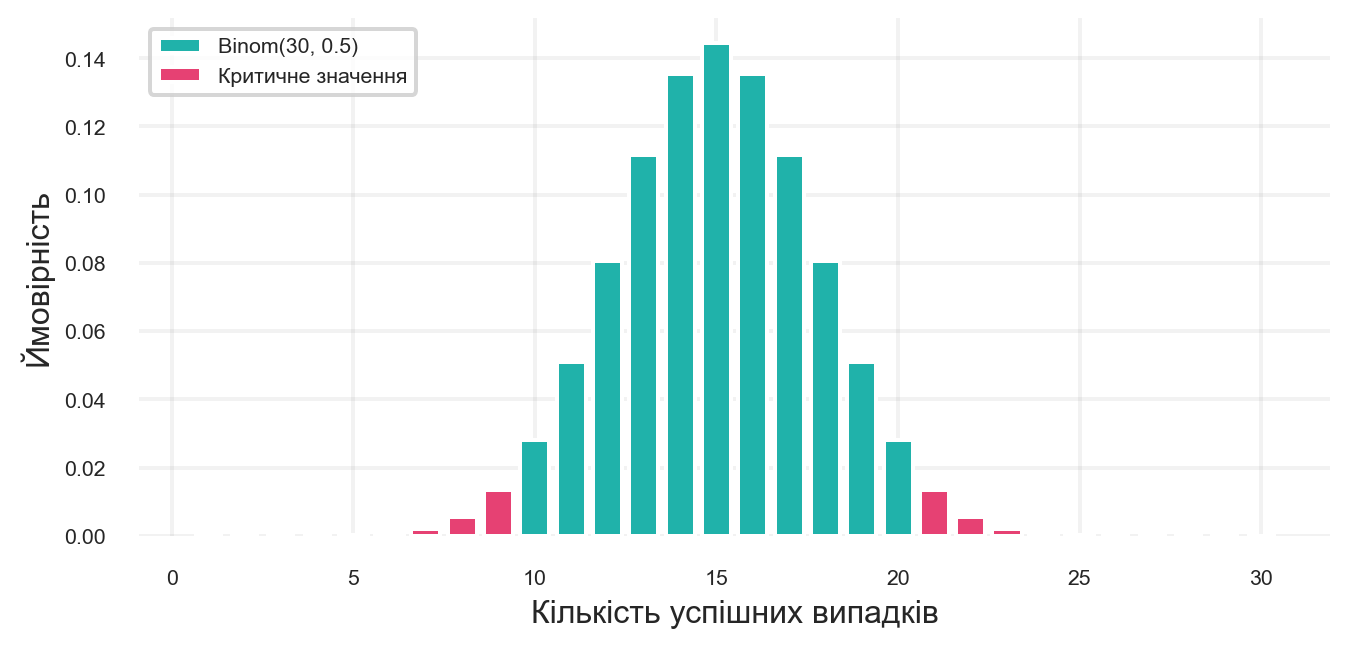
Подивимося, який вигляд матиме критична область у такому разі. Для цього зобразимо функцію ймовірностей біноміального розподілу, а також критичну область.


Рисунок 1.6: Двостороння критична область для критерію \(С = 6\)

На рисунку 1.6 можемо побачити, що якщо тепер відкидати відхилення за \(Q \geqslant 20\), то необхідно відкидати й \(Q \leqslant 10\), а отже, загальна площа стовпців буде вже приблизно \(0.1\). Тому за рівня значущості \(0.05\) й \(20\) успіхів гіпотеза вже не відкинеться.

Якщо ж виставити \(C = 6\), то така область уже підходить, площа стовпців \(\approx 0.043 < 0.05\).

Щоб вибрати порогову константу за формулою, можна помітити, що критична область симетрична, а значить праворуч площа не повинна бути більшою, ніж \(\frac{\alpha}{2}\). А таку задачу ми вже вміємо розв’язувати.

Реалізуємо функцію на Python.


1def find_crit_subs_two_sided(n, mu, alpha):
    """
    Знаходить критичне значення для двостороннього біноміального розподілу.

    n: кількість спостережень
    mu: ймовірність успіху
    alpha: рівень значущості
    """
2    binom_dist = binom(n, mu)
3    return n / 2 - binom_dist.ppf(alpha / 2) + 1

result = find_crit_subs_two_sided(30, 0.5, 0.05)
print(f"Критичне значення для n = 30, mu = 0.5, alpha = 0.05: {result}")
1
Функція для знаходження критичного значення.
2
Створюємо об’єкт біноміального розподілу.
3
Знаходимо критичне значення.
Критичне значення для n = 30, mu = 0.5, alpha = 0.05: 6.0

1.5.2 Як знайти \(p\)-значення

Критерій має вигляд

\[ S = \{|Q(\xi) - 15| \geqslant C\} \]

Позначимо відхилення суми від 15 як \(\Delta(\xi) = |Q(\xi) - 15|\), тоді ми маємо критерій

\[ S = \{\Delta(\xi) \geqslant C\} \tag{1.12}\]

Тобто більш екстремальними вважатимуться ті значення суми, що знаходяться далі від 15. Щоб обчислити \(p\)-значення, доведеться порахувати суму площ із двох сторін окремо.


1def pvalue_two_sided_sym(n, q):
    """
    Обчислює p-значення для двостороннього біноміального розподілу.

    n: кількість спостережень
    q: значення статистики критерію
    """
2    binom_h0 = binom(n=n, p=0.5)
3    diff = np.abs(q - 15)
4    right_sq = 1 - binom_h0.cdf(15 + diff - 1)
5    left_sq = binom_h0.cdf(15 - diff)
6    return left_sq + right_sq

result = pvalue_two_sided_sym(30, 21)
print(f"p-значення для q = 21: {result:.4f}")
1
Функція для обчислення \(p\)-значення.
2
Створюємо об’єкт біноміального розподілу.
3
Обчислюємо відхилення від 15.
4
Обчислюємо праву площу.
5
Обчислюємо ліву площу.
6
Повертаємо суму площ.
p-значення для q = 21: 0.0428


Насправді через симетричність розподілу ліва й права площа виходять однаковими, тому можна порахувати площу з одного боку й помножити на 2.


def pvalue_two_sided_sym_simple(n, q):
    """
    Обчислює p-значення для двостороннього біноміального розподілу.

    n: кількість спостережень
    q: значення статистики критерію
    """
    binom_h0 = binom(n=n, p=0.5)
    diff = np.abs(q - 15)
    right_sq = 1 - binom_h0.cdf(15 + diff - 1)
    return 2 * right_sq

result = pvalue_two_sided_sym_simple(30, 21)
print(f"p-значення для q = 21: {result:.4f}")
p-значення для q = 21: 0.0428


Тепер навіть у разі \(20\) орлів \(p\)-значення \(> 0.05\), тому відкидати будемо значення, починаючи з \(21\) й менші або такі, що дорівнюють \(9\).

1.5.3 Випадок із несиметричним розподілом

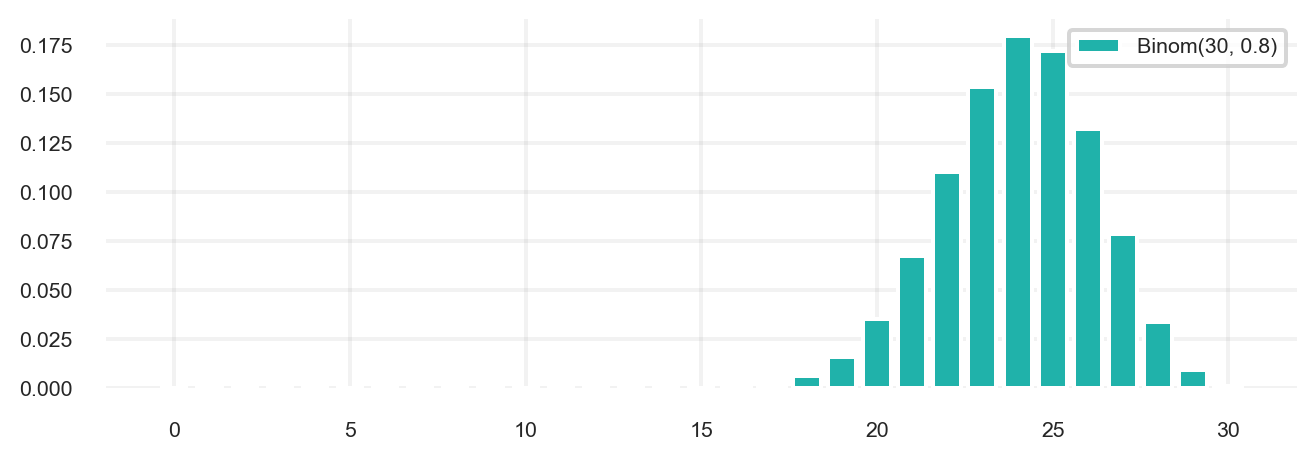
Коли розподіл за справедливості \(H_0\) несиметричний, відхилення від очікуваного значення в різні боки можуть бути по-різному критичними. Як приклад розглянемо також біноміальний розподіл, але з імовірністю успіху \(0.8\).

Тоді можна ліву і праву критичні області побудувати окремо, виділивши на них по \(\frac{\alpha}{2}\) площі. Праву область ми вже вміємо шукати, знайдемо ліву.


fig, ax = plt.subplots(figsize=(8, 2.5))
1binom_h0_nonsym = binom(n=30, p=0.8)
2probs = binom_h0_nonsym.pmf(np.arange(31))

plt.bar(np.arange(31), probs, color=turquoise, label="Binom(30, 0.8)")
plt.legend()
plt.show()
1
Створюємо об’єкт біноміального розподілу з ймовірністю успіху \(0.8\).
2
Обчислюємо ймовірності для всіх можливих значень.
Рисунок 1.7: Біноміальний розподіл з імовірністю успіху \(0.8\)

Для того, щоб побудувати двосторонній критерій, потрібно знайти ліворуч і праворуч області, площа яких становить не більше, ніж \(\frac{\alpha}{2}\). Для правого боку ми вже розв’язували таку задачу, розв’яжемо для лівого.

Шукаємо \(C\), таке що

\[ P(Q(\xi) \leqslant C) \leqslant \frac{\alpha}{2} \tag{1.13}\]

Спочатку знайдемо перше число, де ймовірність \(\geqslant \frac{\alpha}{2}\). А це за визначенням \(\frac{\alpha}{2}\)-квантиль. Достатньо взяти попереднє число, і воно буде задовольняти нашій умові.


def two_sided_criterion_nonsym(n, mu, alpha):
    """
    Знаходить критичні значення для двостороннього біноміального розподілу.

    n: кількість спостережень
    mu: ймовірність успіху
    alpha: рівень значущості
    """
    binom_h0 = binom(n=n, p=mu)
    c2 = binom_h0.ppf(1 - alpha/2) + 1
    c1 = binom_h0.ppf(alpha/2) - 1
    return c1, c2

result = two_sided_criterion_nonsym(30, 0.8, 0.05)
print(f"Критичні значення для n = 30, mu = 0.8, alpha = 0.05: {result}")
Критичні значення для n = 30, mu = 0.8, alpha = 0.05: (18.0, 29.0)


Отже, наш критерій для перевірки гіпотези

\[ H_0: \mu = 0.8 \]

\[ H_1: \mu \neq 0.8 \]

має вигляд

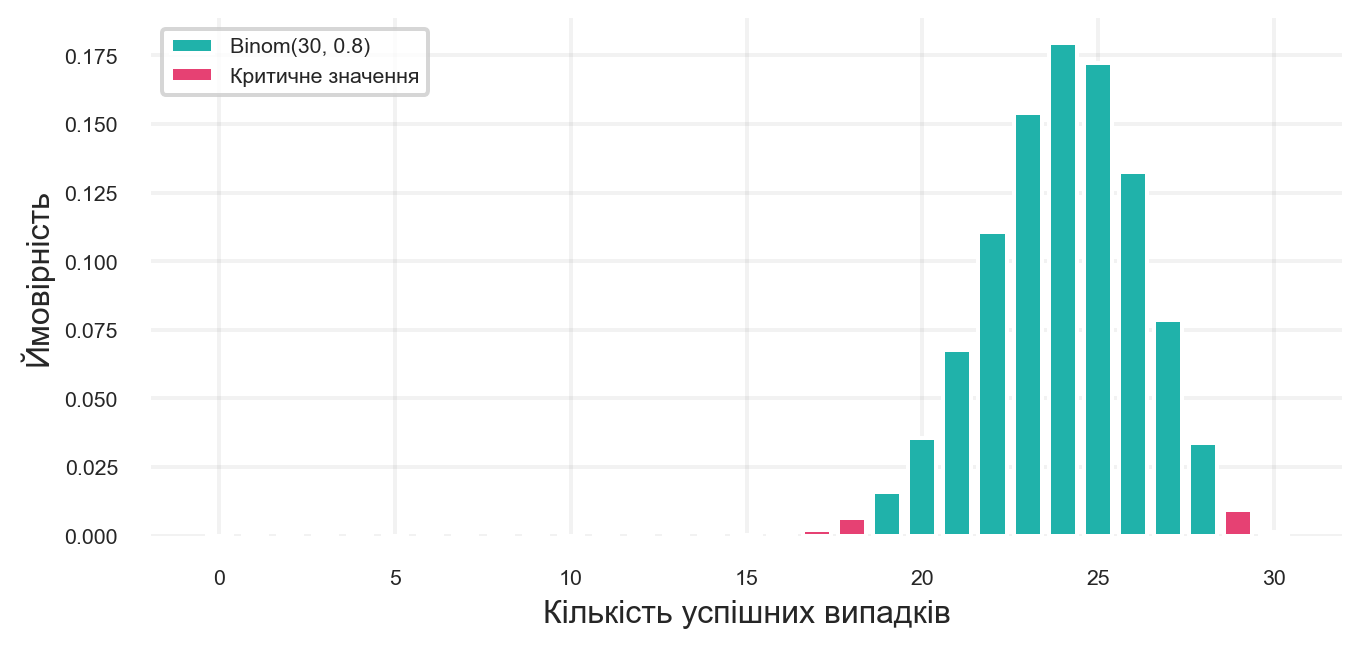
\[ S = \{Q(\xi) \leqslant 18\} \cup \{Q(\xi) \geqslant 29\} \]

Тут межа \(29\) уже має логічний вигляд, бо треба спростувати 80% орлів/успіхів, а для цього потрібна велика їхня кількість.

Зобразимо критичну область на графіку.


1C1, C2 = two_sided_criterion_nonsym(30, 0.8, 0.05)

2x = np.arange(31)

3plt.bar(x, probs, color=turquoise, label="Binom(30, 0.8)")
4plt.bar(x[x <= C1], probs[x <= C1],
        color=red_pink, label="Критичне значення")
5plt.bar(x[x >= C2], probs[x >= C2],
        color=red_pink)
        
plt.xlabel("Кількість успішних випадків")
plt.ylabel("Ймовірність")
plt.legend(loc = 'upper left')
plt.show()
1
Знаходимо критичні значення
2
Створюємо масив значень для графіка.
3
Будуємо графік біноміального розподілу.
4
Відзначаємо ліву критичну область.
5
Відзначаємо праву критичну область.
Рисунок 1.8: Двостороння критична область для критерію \(C_1 = 18, C_2 = 29\)

1.5.4 \(p\)-значення для несиметричного розподілу

Цей критерій — об’єднання двох критеріїв рівня значущості \(\frac{\alpha}{2}\), для кожного з яких можна порахувати \(p\)-значення. Позначимо їх як \(p_1, p_2\). Перший критерій відкидається при \(p_1 \leqslant \frac{\alpha}{2}\), другий при \(p_2 \leqslant \frac{\alpha}{2}\). А наш об’єднаний, коли виконано одну з цих умов, тобто

\[ 2p_1 \leqslant \alpha \vee 2p_2 \leqslant \alpha \Leftrightarrow 2 \cdot \min(p_1, p_2) \leqslant \alpha \tag{1.14}\]

Отже, можна рахувати \(p\)-значення як \(2 \min(p_1, p_2)\) й порівнювати з \(\alpha\).

Проведемо аналогію із симетричним випадком: якщо сума опинилася в лівій частині, то потрібно порахувати \(p\)-значення лівого критерію і помножити на 2. Якщо сума опинилася в правій частині, то потрібно порахувати \(p\)-значення правого критерію і помножити на 2.


1def pvalue_two_sided(n, q, mu=0.5):
    """
    Обчислює p-значення для двостороннього біноміального розподілу.

    n: кількість спостережень
    q: значення статистики критерію
    mu: ймовірність успіху
    """
2    binom_h0 = binom(n=n, p=mu)
3    pvalue_left = binom_h0.cdf(q)
4    pvalue_right = 1 - binom_h0.cdf(q - 1)
5    return 2 * min(pvalue_left, pvalue_right)

result = pvalue_two_sided(30, 28, 0.8)
print(f"p-значення для q = 28: {result:.4f}")
1
Функція для обчислення \(p\)-значення:
2
Створюємо об’єкт біноміального розподілу.
3
Обчислюємо \(p\)-значення для лівого критерію.
4
Обчислюємо \(p\)-значення для правого критерію.
5
Повертаємо \(p\)-значення.
p-значення для q = 28: 0.0884


Видно, що \(p\)-значення \(> 0.05\), отже, на рівні значущості \(0.05\) навіть \(28\) успіхів недостатньо, щоб відкинути ймовірність успіху в \(80\%\).

Зауважимо, що ця ж функція працює і для симетричного випадку, повертаючи той самий результат.


result = pvalue_two_sided(n=30, q=20, mu=0.5)
print(f"p-значення для q = 20: {result:.4f}")
p-значення для q = 20: 0.0987


result = pvalue_two_sided_sym(n=30, q=20)
print(f"p-значення для q = 20: {result:.4f}")
p-значення для q = 20: 0.0987


1.6 Готові функції

Звісно, можна використати готові функції з бібліотеки scipy. Для цього використаємо функцію binomtest, котра має параметри:

  • k — кількість успіхів
  • n — кількість спостережень
  • p — ймовірність успіху
  • alternative — тип гіпотези:
    • two-sided: двостороння
    • greater: правостороння
    • less: лівостороння


1from scipy.stats import binomtest

2result = binomtest(19, 30, 0.5, alternative='two-sided')

3print(f"Статистика: {result.statistic:.2f}")
print(f"p-значення: {result.pvalue:.4f}")
1
Імпортуємо функцію binomtest.
2
Викликаємо функцію з параметрами.
3
Виводимо статистику та \(p\)-значення.
Статистика: 0.63
p-значення: 0.2005

1.7 Питання для самоперевірки

Загальні поняття та постановка задачі:

  1. Що таке генеральна сукупність та вибірка в контексті наведеного прикладу з онлайн-курсами?
  2. Що позначають символи \(\mu\) та \(\hat{\mu}\)? Яка між ними різниця?
  3. Чому спостережувана частка успіхів у вибірці (\(\hat{\mu}\)) може не точно відображати справжню частку (\(\mu\)) в генеральній сукупності?
  4. Який розподіл ймовірностей описує результат для одного студента (успіх/невдача)?
  5. Який розподіл ймовірностей описує загальну кількість успішних випадків серед \(n\) студентів? Які параметри має цей розподіл?

Статистичні гіпотези та критерій:

  1. Що таке нульова (\(H_0\)) та альтернативна (\(H_1\)) гіпотези? Сформулюйте їх для прикладу з онлайн-курсами.
  2. Що таке статистичний критерій? Яка його мета?
  3. Що таке статистика критерію (\(Q\)) та критичне значення (\(C\)) у контексті біноміального тесту?
  4. Що таке критична область критерію?

Помилки та рівень значущості:

  1. Які два типи помилок можливі при перевірці статистичних гіпотез? Опишіть їх (хибно позитивна та хибно негативна). Яка помилка була важливішою для інвесторів у прикладі?
  2. Що таке рівень хибнопозитивних спрацьовувань (FPR)? Як він пов’язаний з нульовою гіпотезою?
  3. Що таке рівень значущості (\(\alpha\))? Як він використовується для вибору критичного значення (\(C\))?
  4. Як розрахувати FPR для заданого критичного значення \(C\), використовуючи функцію щільності ймовірностей (PMF) біноміального розподілу?

Обчислення в Python (scipy.stats):

  1. Які функції з scipy.stats.binom використовуються для обчислення:
    • Ймовірності конкретної кількості успіхів (\(P(Q=k)\))?
    • Кумулятивної ймовірності (\(P(Q \le k)\))?
    • Квантиля розподілу?
  2. Як можна знайти критичне значення \(C\) для правостороннього тесту (\(H_1: \mu > \mu_0\)) з заданим рівнем значущості \(\alpha\), використовуючи функцію квантиля (ppf)?

P-значення:

  1. Що таке p-значення (p-value)? Як воно інтерпретується?
  2. Як визначається поняття “більш екстремального” значення статистики для правостороннього тесту?
  3. Як розраховується p-значення для правостороннього біноміального тесту, знаючи спостережувану кількість успіхів \(q\)?
  4. Яке правило прийняття рішення щодо \(H_0\) використовується на основі p-значення та рівня значущості \(\alpha\)?
  5. Яка перевага використання p-значення порівняно з визначенням критичної області?

Двосторонні критерії:

  1. Коли використовують двосторонні критерії? Як формулюються гіпотези (\(H_0\) та \(H_1\)) для двостороннього тесту?
  2. Як зазвичай визначається критична область для двостороннього критерію при симетричному розподілі (наприклад, \(Binom(n, 0.5)\))? Як рівень значущості \(\alpha\) розподіляється між “хвостами”?
  3. Як розраховується p-значення для двостороннього критерію при симетричному розподілі?
  4. Як визначається критична область для двостороннього критерію, коли розподіл статистики при \(H_0\) є несиметричним (наприклад, \(Binom(n, 0.8)\))?
  5. Як розраховується p-значення для двостороннього критерію при несиметричному розподілі?

Готові функції:

  1. Як можна виконати біноміальний тест (односторонній або двосторонній) за допомогою функції binomtest з бібліотеки scipy.stats? Які основні параметри вона приймає і що повертає?

  1. У статистиці \(\hat{\mu}\) позначається як оцінка параметра \(\mu\).↩︎

  2. Метод integers() генерує випадкові цілі числа в заданому діапазоні. Аргумент endpoint вказує, що верхня межа включається у діапазон.↩︎

  3. Розподіл Бернуллі — це дискретний розподіл ймовірностей, який моделює випадковий експеримент з двома можливими результатами: успіхом або невдачею.↩︎

  4. Біноміальний розподіл моделює кількість успішних випадків у послідовності незалежних випробувань. Сума \(n\) незалежних випадкових величин з розподілу Бернуллі підпорядковується біноміальному розподілу.↩︎

  5. Англ. cyan, від грец. κυανouς — “блакитний”, “лазуровий”.↩︎