2Статистична потужність, ефект та довірчі інтервали
2.1 Статистична потужність
2.1.1 Хибно негативні помилки
Раніше під час побудови критеріїв ми звертали увагу тільки на \(\alpha\), рівень значущості критерію. Але цей параметр контролює лише хибнопозитивну помилку (False Positive), а саме ймовірність, що критерій прийме \(H_1\) за умови вірності \(H_0\).
Але є ще один вид помилок, які може допустити критерій — хибно негативні помилки (False Negative). Це випадки, коли критерій приймає \(H_0\) за умови вірності \(H_1\). Це важливо, оскільки вони можуть вказувати на те, що критерій не чутливий до змін, які відбуваються в даних.
Випадок, коли ймовірність FPR \(< \alpha\), але при цьому ймовірність хибно негативні помилки (False Negative Rate, FNR) величезна, можна навести легко. Для цього достатньо ніколи не відкидати гіпотезу, взявши критерій \(S \equiv 0\).
Наведемо приклад, коли помилки False Negative відбуваються не завжди, але критерії є все одно нечутливими.
2.1.2 Критерій пори року
Поставимо гіпотезу про те, що зараз на вулиці літо. Для перевірки можна було б, звісно, подивитися в календар, але ми зробимо інакше.
\[
H_0: \text{ на вулиці літо}
\]
\[
H_1: \text{ на вулиці не літо}
\]
Подивимося у вікно і визначимо, чи йде там сніг. Якщо він йде, то це непоганий доказ того, що зараз не літо, а отже можна відкинути \(H_0\).
Порахуємо FPR та FNR для цього критерію. Ми знаємо, що влітку сніг іде дуже рідко (ймовірність помилки нижча за \(0.1\%\)), тож це точно критерій рівня значущості \(0.001\), чого зазвичай достатньо для критеріїв.
Але що з FNR? Розглянемо конкретний випадок: зараз вересень. Оскільки у вересні майже завжди немає снігу, можна сказати, що FNR більша за \(90\%\), отже, цей критерій насправді мало дієвий.
За \(\alpha = 0.001\), як у першому випадку, отримуємо ймовірність FNR \(0.999 > 0.9\), тобто за однакового рівня значущості з першим критерієм, другий критерій частіше припускається хибно негативної помилки.
2.1.3 Потужність
У статистиці заведено позитивним результатом вважати відкидання нульової гіпотези, бо зазвичай підтвердження альтернативи означає наявність бізнес-результату. Тому вважається хорошим критерій, який частіше дає змогу виявити бізнес-результат. І рахують тоді не ймовірність хибно негативної помилки, а потужність, що дорівнює ймовірності відкинути нульову гіпотезу за вірності \(H_1\), тобто ймовірність істинно позитивного результату (True Positive Rate, TPR) (Cohen (1988)).
\[
\text{Power}_S = 1 - FNR
\tag{2.1}\]
Коли альтернатива \(H_1\) складається з множини результатів, потужність розглядають як функцію від результату. Наприклад, можна порахувати потужність першого та другого критеріїв взимку й восени.
Зазвичай завдання пошуку найкращого критерію формулюється як пошук якомога потужнішого критерію за заданого рівня значущості \(FPR \leqslant \alpha\). Але ми сказали, що потужність — функція від параметра, у нашому випадку від місяця.
Якщо ми застосовуватимемо критерій у січні, то потужнішим буде перший критерій, а якщо в травні, то потужнішим буде другий критерій. Тому потрібно розуміти, коли буде застосовуватися критерій, а отже, ми шукаємо найпотужніший критерій у галузі, яка нас цікавить.
Хоча в реальності в травні потужність обох критеріїв настільки низька, що вони просто не приносять користі, й використовувати їх не має сенсу.
2.2 Потужність для біноміального розподілу
Застосуємо нові знання про потужність для нашої задачі з освітнім сервісом. З бізнес-міркувань ми вже вибрали \(\alpha = 0.05\), а отже, знаємо, що ми неправильно відкидаємо гіпотезу \(H_0:\ \mu = 0.5\) з ймовірністю не більше, ніж \(5\%\). Тобто цим обмежена ймовірність хибно позитивної помилки.
А з якою ймовірністю ми будемо правильно відкидати гіпотезу? І яка в нас буде ймовірність хибно негативної помилки? На це запитання якраз відповість формула потужності.
Тобто якщо отримуємо хоча б \(20\) успішних підписок, то відкидаємо \({H}_0\).
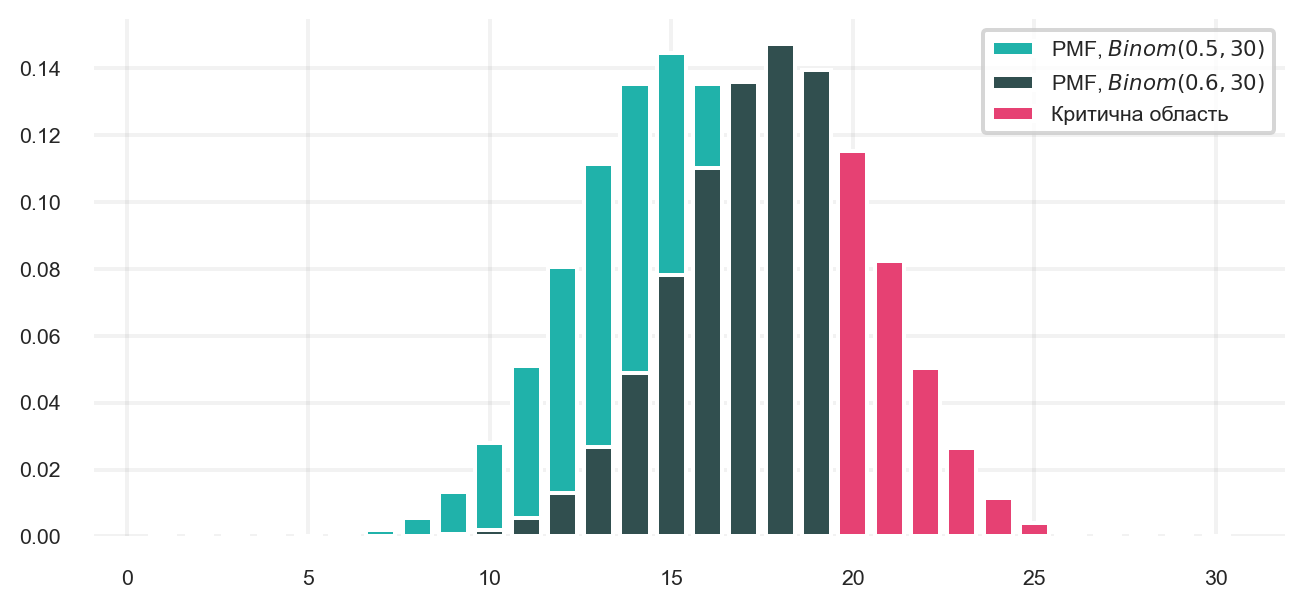
Зауважимо, що потужність залежить від того, яке значення \(\mu\) у нашій генеральній сукупності. Зафіксуємо спочатку параметр \(\mu = 0.6\) й порахуємо потужність для нього. Якщо істинний параметр такий, то статистика \(Q\) має розподіл \(Binom(30, 0.6)\).
Обчислюємо ймовірності для альтернативної гіпотези
8
Будуємо гістограму для альтернативної гіпотези
9
Будуємо гістограму для критичної області
Рисунок 2.1: Потужність критерію для \(\mu = 0.6\)
Як і раніше, нас цікавить імовірність отримати \(20\) або більше успіхів. Але якщо раніше ми дивилися на неї для розподілу з \(\mu=0.5\) й хотіли, щоб вона була меншою за \(5\%\), то тепер ми дивимося за \(\mu = 0.6\) та прагнемо зробити цю величину якомога більшою. Порівняно з обчисленням FPR формула не зміниться, змінюється тільки \(\mu\)
Видно, що потужність близько \(30\%\). Це досить маленьке значення, адже якщо наш продукт прибутковий, то ми побачимо це за допомогою нашого тесту тільки з імовірністю в \(30\) відсотків. Ми легко можемо пропустити ефект.
Що ж можна зробити, щоб зробити потужність вищою? Щоб розібратися, реалізуємо функцію потужності в загальному вигляді.
1def get_stat_power(N, mu_h0, mu_alternative, alpha):""" Функція потужності для біноміального розподілу N: розмір вибірки mu_h0: ймовірність успіху в нульовій гіпотезі mu_alternative: ймовірність успіху в альтернативній гіпотезі alpha: рівень значущості """2 binom_h0 = binom(n=N, p=mu_h0)3 binom_alternative = binom(n=N, p=mu_alternative)4 critical_value = binom_h0.ppf(1- alpha) +15return1- binom_alternative.cdf(critical_value -1)result = get_stat_power(30, 0.5, 0.6, alpha=0.05)print(f"Потужність: {result:.1%}")
1
Функція потужності:
2
Розподіл нульової гіпотези
3
Розподіл альтернативної гіпотези
4
Критичне значення
5
Повертаємо потужність
Потужність: 29.1%
Коли в житті ми спостерігаємо якесь явище і бачимо його лише кілька разів, ми не впевнені в тому, що воно не випадкове. Якщо ж бачимо його досить часто, то вже складаємо закономірності. Так і в статистиці. Коли ми подивилися на 30 потенційних підписок, ми помічаємо, що частка доставок більше половини. Але ми все ще не впевнені. Щоб отримати більше впевненості, потрібно провести більше спостережень, тобто знайти більше пробних клієнтів.
Подивимося, що буде, якщо ми проведемо експеримент на 300 клієнтах.
result = get_stat_power(300, 0.5, 0.6, alpha=0.05)print(f"Потужність при N=300: {result:.1%}")
Потужність при N=300: 96.6%
Бачимо, що потужність уже дуже близька до \(100\%\). Але провести 300 пробних занять набагато затратніше, ніж 30. І за ресурсами, і за часом. Тому зазвичай балансують між потужністю і тривалістю/витратами експерименту.
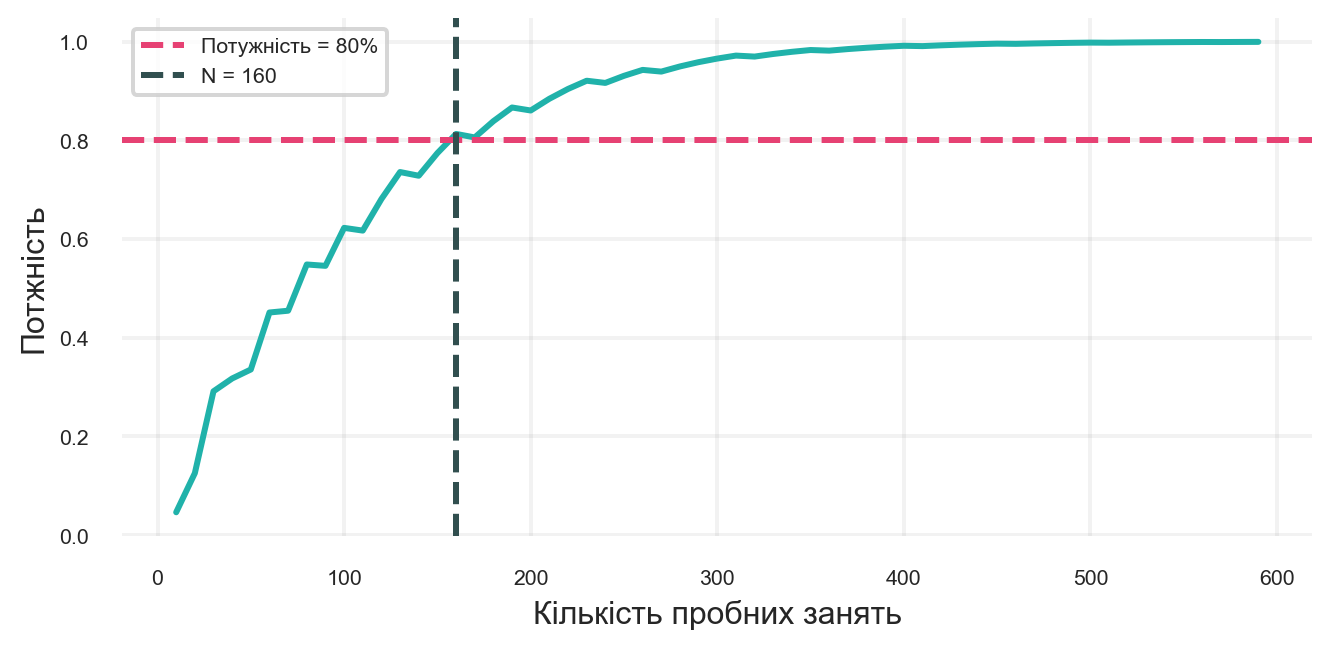
Прийнято вважати, що прийнятною для роботи потужністю вважається \(80\%\). Подивимося, як змінюється потужність при зростанні розміру вибірки, і скільки потрібно провести експериментів, щоб детектувати ефект при \(\mu = 0.6\) у \(80\%\) випадків.
Додаємо горизонтальну лінію для потужності \(80\%\)
5
Знаходимо мінімальну кількість пробних занять, щоб потужність була більшою за \(80\%\)
6
Додаємо вертикальну лінію для мінімальної кількості пробних занять
Рисунок 2.2: Залежність потужності від розміру вибірки для \(\mu = 0.6\)
Бачимо, що для потужності в \(80\%\) достатньо набрати 160 пробних занять.
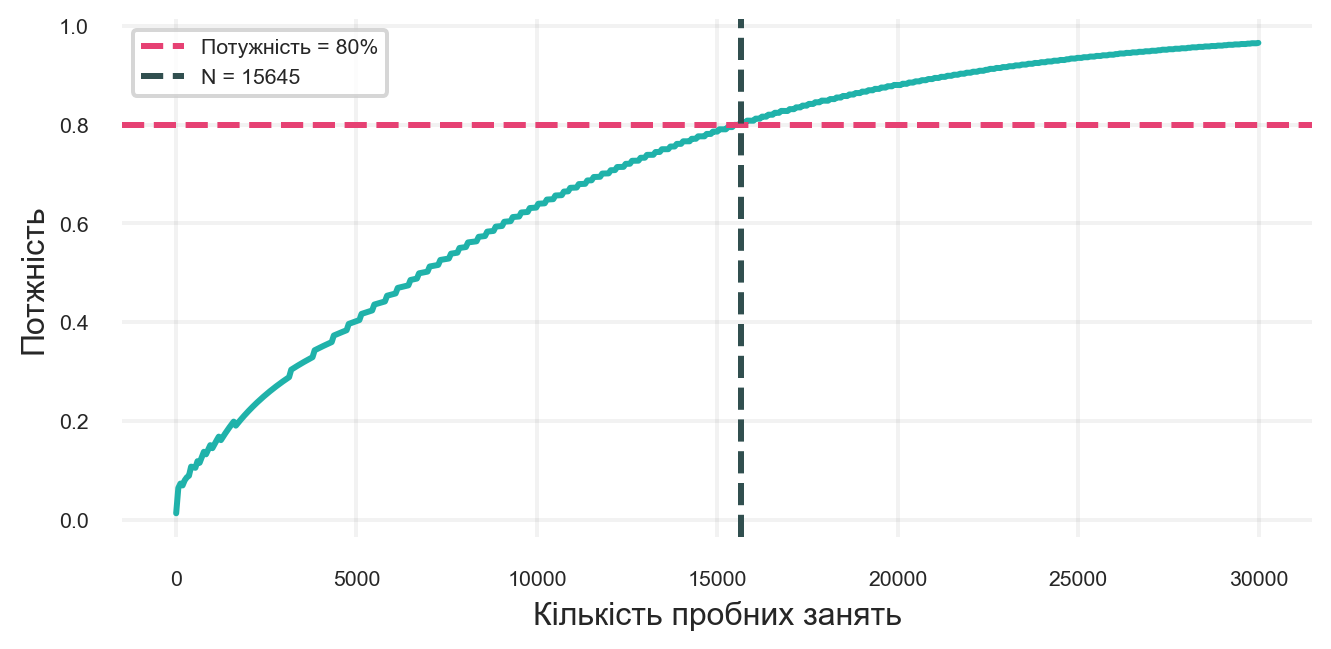
А що, якщо ми хочемо детектувати ще менший ефект? Наприклад, якщо хочемо відкидати гіпотезу за \(\mu = 0.51\). Часто поліпшення ймовірності успіху на \(1\%\) може бути значущим для продукту, тому це питання не позбавлене сенсу.
Додаємо горизонтальну лінію для потужності \(80\%\)
5
Знаходимо мінімальну кількість пробних занять, щоб потужність була більшою за \(80\%\)
6
Додаємо вертикальну лінію для мінімальної кількості пробних занять
Рисунок 2.3: Залежність потужності від розміру вибірки для \(\mu = 0.51\)
Бачимо, що потрібно понад 15 тисяч клієнтів, щоб детектувати такий ефект! Дуже складно знайти стільки пробних клієнтів. Але потрібно замислитися над питанням, а чи варто це робити? У нашому випадку, якщо ймовірність успіху \(51\%\), то прибуток із замовлень буде невеликий, і вкладення інвесторів, звісно, окупатимуться, але дуже довго. Тому збільшення на \(1%\) для нашого завдання не значуще практично, а отже, не потрібно намагатися набирати 15 тисяч людей, а можна зупинитися і на 160.
Перед кожним експериментом аналітику варто замислюватися над питанням тривалості тесту і кількості учасників. Для цього потрібно зрозуміти:
Який ефект є для завдання практично значущим?
Скільки знадобиться випробовуваних, щоб детектувати цей ефект частіше, ніж у \(80\%\) випадків?
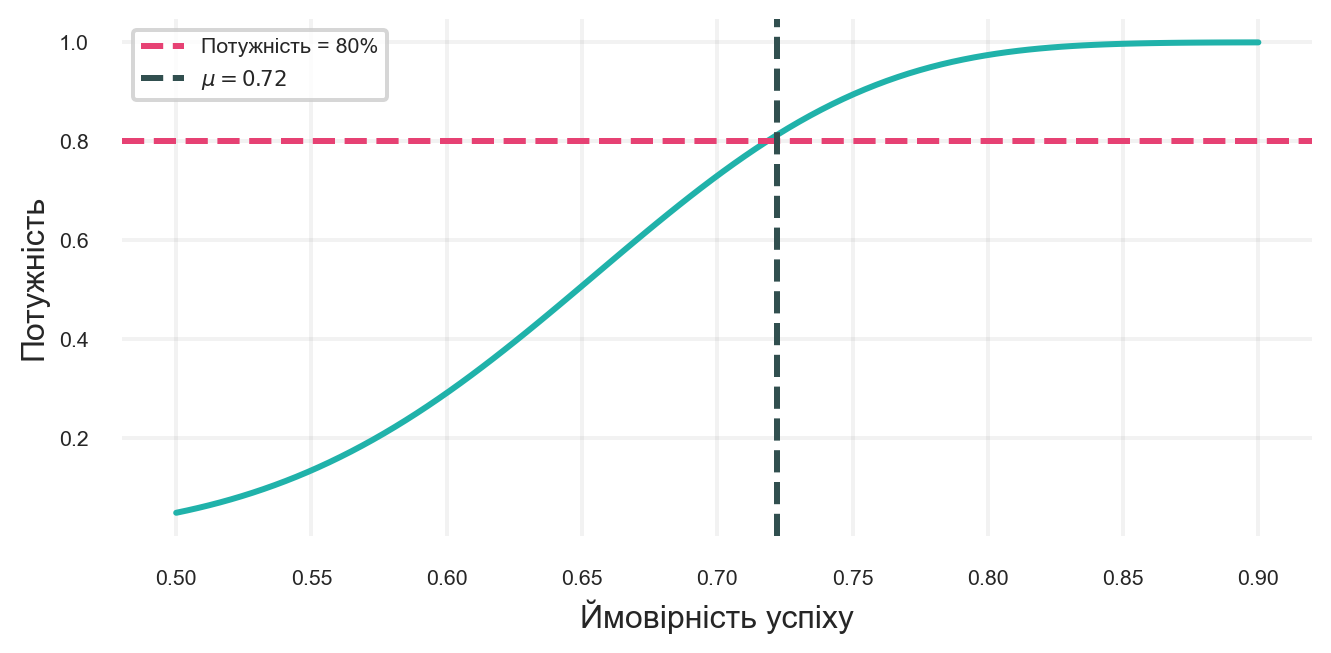
З графіків видно, що для детектування меншого ефекту потрібен більший розмір вибірки. Подивимося, як для фіксованого \(N=30\) змінюється потужність для різних параметрів \(\mu\).
Обчислюємо потужність для різних параметрів \(\mu\)
3
Будуємо графік
4
Додаємо горизонтальну лінію для потужності \(80\%\)
5
Знаходимо мінімальну ймовірність успіху, щоб потужність була більшою за \(80\%\)
6
Додаємо вертикальну лінію для мінімальної ймовірності успіху
Рисунок 2.4: Залежність потужності від параметра \(\mu\)
У нашому експерименті ми добре детектуємо ефект, тільки якщо ймовірність успіху в генеральній сукупності хоча б \(72\%\).
2.3 Мінімальна величина ефекту
Вище на Рисунок 2.4 ми побачили, що з хорошою потужністю понад \(80\%\) ми можемо помітити ефект у \(22\) процентних пункти. Причому це можна порахувати навіть до проведення експерименту. У нашому випадку таке збільшення успішності щодо \(0.5\) цілком можливо, і з ним можна працювати. Але коли аналітики перевіряють зміни, найчастіше очікуваний ефект коливається в районі одного, максимум двох відсотків! Для подібних змін не підійде обрана постановка експерименту, а значить і проводити його не має сенсу.
Тому перед запуском експериментів аналітики повідомляють мінімальну величину ефекту, яку можна задетектувати (Minimal Detectable Effect, MDE).. У нашому випадку \(MDE = +22\) процентних пункти (Cohen (1988)).
Більш формально, MDE для гіпотези \(H_0: \mu = \mu_0\) — це мінімальний ефект \(\delta\), за якого критерій рівня значущості \(\alpha\) для перевірки цієї гіпотези за істинного параметра \(\mu = \mu_0 + \delta\) та розміру вибірки \(N\) відкидатиме \({H}_0\) з потужністю більшою, ніж \(1 - \beta\).
Найчастіше беруть \(1 - \beta = 80\%\). Напишемо функцію, яка обчислюватиме MDE підбором.
1def binom_test_mde_one_sided(N, mu0, alpha=0.05, min_power=0.8):""" Розрахунок MDE для біноміального тесту N: розмір вибірки mu0: параметр нульової гіпотези alpha: рівень значущості min_power: мінімальна потужність """2 delta_grid = np.linspace(0, 1- mu0, 500)3 power = get_stat_power(N, mu0, mu0 + delta_grid, alpha=alpha)4 fit_delta = delta_grid[power >= min_power]5return fit_delta[0]result = binom_test_mde_one_sided(30, 0.5)print(f"MDE: {result:.1%}")
1
Функція, яка обчислює MDE.
2
Створюємо сітку для \(\delta\)
3
Обчислюємо потужність для різних значень \(\delta\)
4
Знаходимо значення \(\delta\), для яких потужність більша за \(80\%\)
5
Повертаємо перше значення \(\delta\), для якого потужність більша за \(80\%\)
MDE: 21.8%
Результат збігається з обчисленнями за графіком Рисунок 2.4. Тобто ми можемо детектувати ефект у \(22\) процентних пункти.
Зазвичай MDE розраховують не просто так, а нерозривно з ним іде питання про визначення розміру вибірки.
У нашому завданні ми знайшли \(30\) клієнтів, не обчислюючи спочатку, скільки їх знадобиться. Але що якщо отриманий MDE занадто великий й потрібно зробити його меншим, оскільки очікувані зміни набагато менші? Тоді вирішується зворотне завдання, За необхідним MDE визначити обсяг вибірки. Якщо ми говоримо, що хочемо детектувати +10 в.п., тобто 60% успішних підписок, то потрібно знайти 160 тестових клієнтів, це видно з попередніх графіків. Якщо 30 осіб нам, наприклад, шукати місяць, такий тест може затягнутися майже на півроку. Тому варто подумати про те, щоб виділити додаткові ресурси на пошук клієнтів, наприклад, залучити маркетологів.
2.4 Довірчі інтервали
Раніше ми навчилися перевіряти гіпотезу \({H}_0: \mu = 0.5\). Як відповідь ми отримуємо лише вердикт “відкидаємо \({H}_0\)” або “не відкидаємо \({H}_0\)”. Однак у вибірці міститься набагато більше інформації, й ми можемо більше зрозуміти про параметр, ніж порівняння з числом \(0.5\).
Якщо гіпотеза \({H}_0\) не відкидається, це означає, що значення \(\mu = 0.5\) припустиме для нашої вибірки. Отримані значення можна пояснити значенням \(\mu = 0.5\). Але якщо у нас є механізм перевірки для будь-якого \(\mu\), ми можемо для всіх значень дізнатися, які з них допустимі, і отримати множину можливих значень \(\mu\). Така множина називається довірчим інтервалом.
Довірчий інтервал рівня \(1 - \alpha\) — множина значень параметра \(\mu_0\), для яких гіпотеза \(\mu = \mu_0\) не відкидається критерієм рівня значущості \(\alpha\) (Casella and Berger (2002)).
З визначення випливає, що різні критерії можуть породжувати різні довірчі інтервали. У цій частині розглянемо, які інтервали породжуються двостороннім критерієм. Для цього з кроком \(0.001\) переберемо значення \(\mu \in [0, 1]\) і перевіримо гіпотези.
1def two_sided_criterion_nonsym(n, mu, alpha):""" Функція, що обчислює критичні значення для двостороннього критерію n: розмір вибірки mu: параметр нульової гіпотези alpha: рівень значущості """2 binom_h0 = binom(n=n, p=mu)3 c2 = binom_h0.ppf(1- alpha/2) +14 c1 = binom_h0.ppf(alpha/2) -15return c1, c26success_cnt =197mu_grid = np.arange(0, 1, 0.001)8mu_no_rejection = []9for mu_h0 in mu_grid: c1, c2 = two_sided_criterion_nonsym(30, mu_h0, alpha=0.05)if success_cnt > c1 and success_cnt < c2: mu_no_rejection.append(mu_h0)print(f'95% довірчий інтервал: [{min(mu_no_rejection)} - {max(mu_no_rejection)}]')
1
Функція, що обчислює критичні значення для двостороннього критерію.
2
Розподіл нульової гіпотези
3
Права межа критичної області
4
Ліва межа критичної області
5
Повертаємо межі критичної області
6
Кількість успіхів
7
Сітка для \(\mu\)
8
Список для значень \(\mu\), для яких \({H}_0\) не відкидається
9
Перебираємо значення \(\mu\) та обчислюємо критичні значення
95% довірчий інтервал: [0.439 - 0.8]
Отримавши такий інтервал, ми відразу можемо зробити висновок, що гіпотеза \({H}_0: \mu = 0.5\) не відкидається, оскільки \(0.5\) лежить у довірчому інтервалі. Але при цьому відразу зрозуміло, що \(\mu \neq 0.4\) на рівні значущості \(\alpha\).
Звичайно ж, у довірчому інтервалі лежить значення \(\mu = \frac{19}{30}\), для якого \(19\) успіхів — це найбільш правдоподібний результат. При цьому інтервал несиметричний щодо точки \(\frac{19}{30}\).
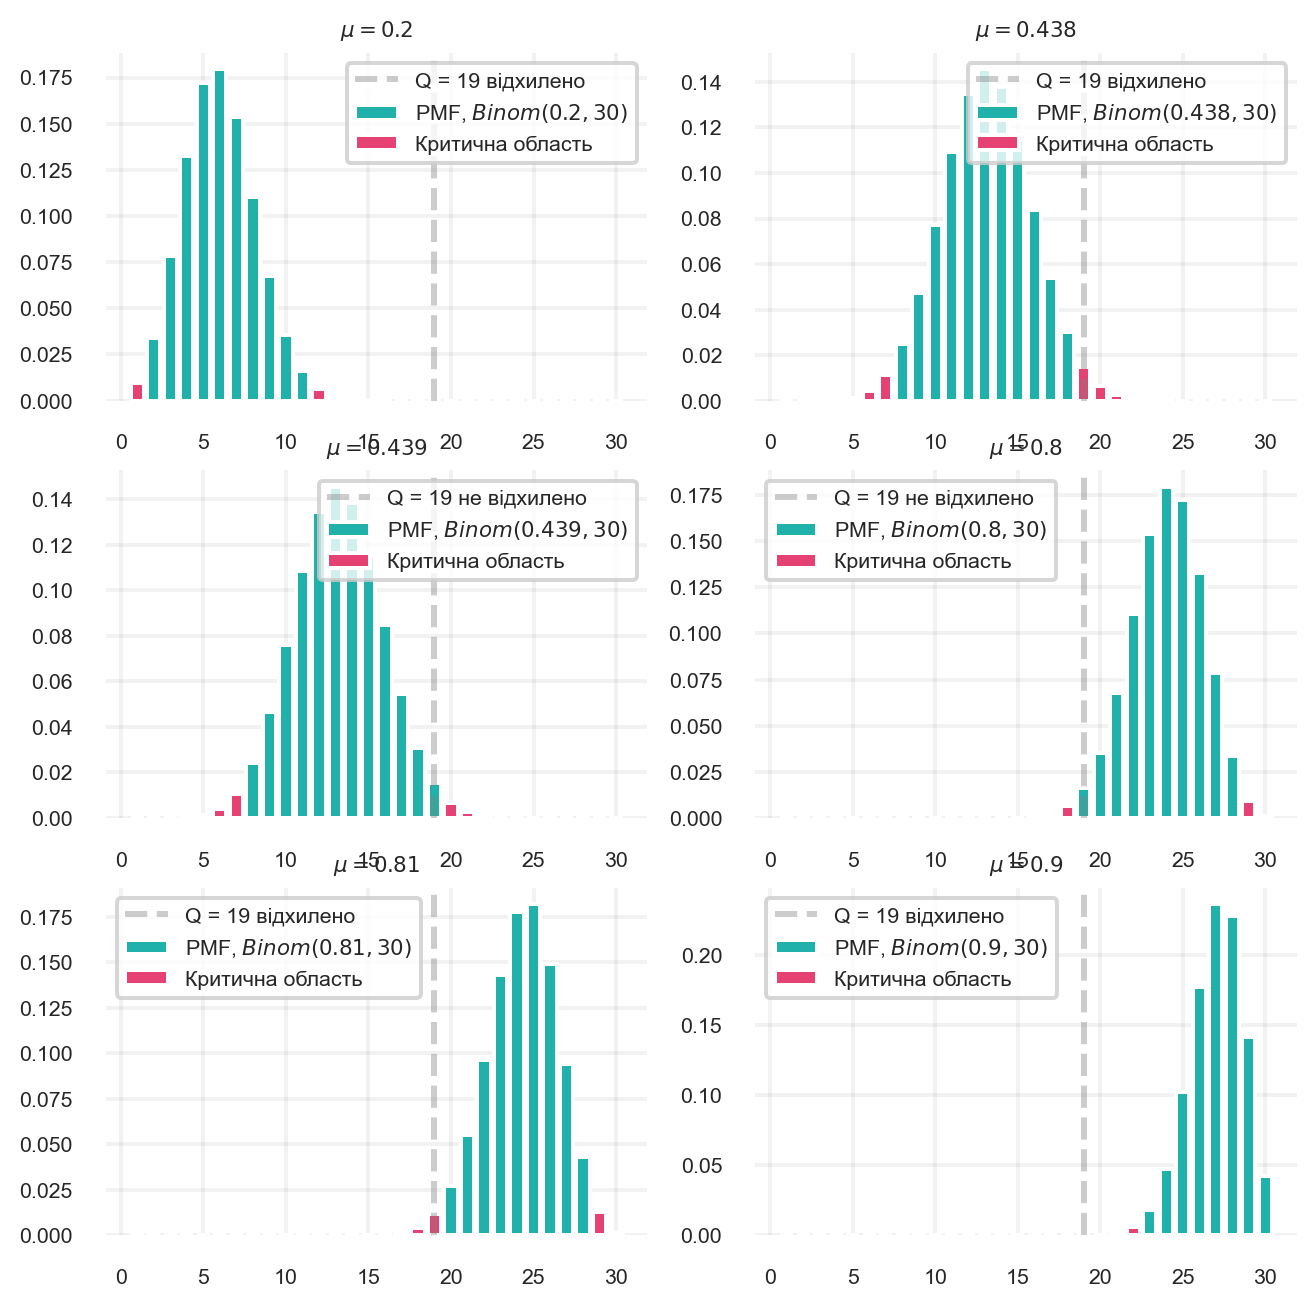
Подивимося, як можна візуально знайти межу інтервалу. Ми отримали \(19\) успіхів. Для кожного \(\mu_0\) статистика \(Q\) має розподіл \(Binom(30, \mu_0)\). Будемо малювати цей розподіл і дивитися, чи потрапляє \(19\) у критичну область.
Рисунок 2.5: Довірчі інтервали для біноміального розподілу
Видно, що зі зростанням \(\mu_0\) гістограма зсувається вправо. І спочатку \(19\) потрапляє в праву критичну область. Потім, починаючи з точки \(0.439\), значення \(19\) вже опиняється поза критичною областю, і тільки з \(\mu_0 = 0.81\) починає потрапляти в ліву критичну область.
Таким чином, ліва межа довірчого інтервалу — це перша точка, коли значення статистики перестало потрапляти до критичної області, а права межа - остання точка, коли значення не потрапляє до правої критичної області.
2.5 Односторонні довірчі інтервали
Насправді, двосторонній критерій потрібен вкрай рідко. Контролювати хибно похитивну помилку нам потрібно тільки для відхилень у бік, корисний для бізнесу. У випадку завдання з освітнім сервісом це отримання більшої конверсії в успіх.
Спробуємо скористатися одностороннім критерієм для побудови довірчого інтервалу.
1def make_binom_criterion(n, mu=0.5, alpha=0.05):""" Функція, що обчислює критичне значення для одностороннього критерію n: розмір вибірки mu: параметр нульової гіпотези alpha: рівень значущості """2 binom_h0 = binom(n=n, p=mu)3 q = binom_h0.ppf(1- alpha)4return q +15success_cnt =196mu_grid = np.arange(0, 1.001, 0.001)7mu_no_rejection = []8for mu_h0 in mu_grid: crit_val = make_binom_criterion(n=30, mu=mu_h0, alpha=0.05)if success_cnt < crit_val: mu_no_rejection.append(mu_h0)print(f'95% довірчий інтервал: [{min(mu_no_rejection)} - {max(mu_no_rejection)}]')
1
Функція, що обчислює критичне значення для одностороннього критерію.
2
Розподіл нульової гіпотези
3
Критичне значення
4
Повертаємо критичне значення
5
Кількість успіхів
6
Сітка для \(\mu\)
7
Список для значень \(\mu\), для яких \({H}_0\) не відкидається
8
Перебираємо значення \(\mu\) та обчислюємо критичне значення
95% довірчий інтервал: [0.467 - 1.0]
Коли ми використовували двосторонній інтервал, ми отримали ліву межу \(0.439 < 0.467\). Виходить, що односторонній інтервал з точки зору лівої межі дає нам більше інформації. При цьому з точки зору правої межі ми втрачаємо інформацію зовсім. Вона дорівнює 1 просто тому, що ймовірність не може бути більшою.
Насправді зазвичай на праву межу не дивляться під час аналізу, коли ми шукаємо позитивний ефект.
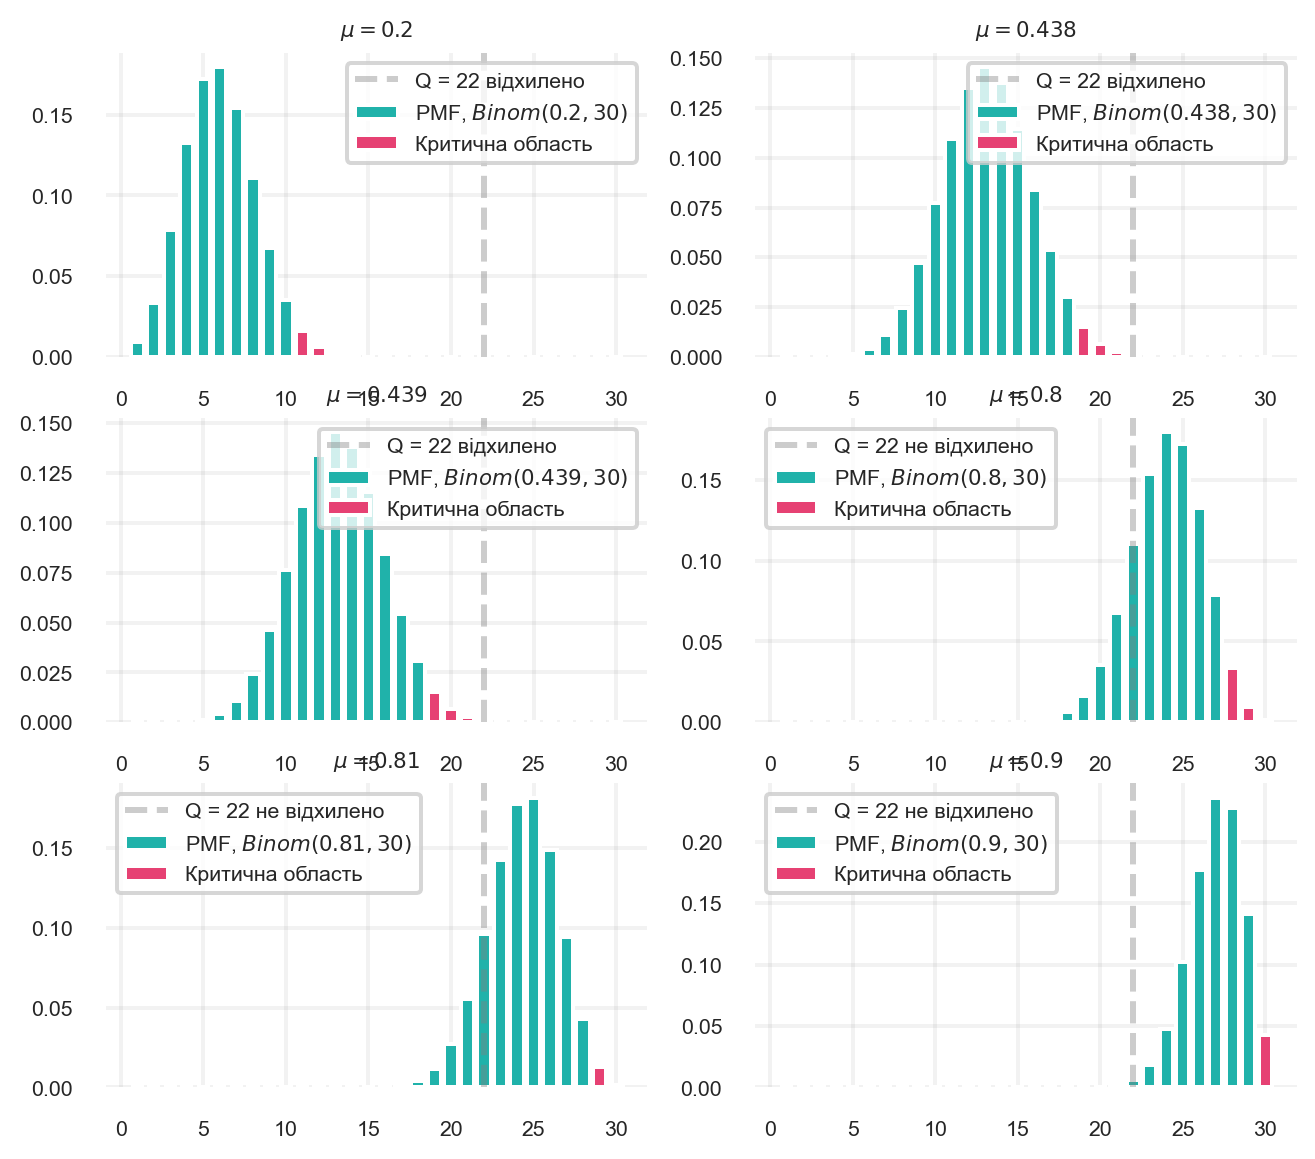
Припустимо, ми отримали не \(19\) успіхів, а \(22\). Побудуємо 2 види інтервалів.
За обома довірчими інтервалами ми робимо висновок, що конверсія значимо відрізняється від \(50\%\). Але односторонній інтервал дає кращу нижню оцінку на ймовірність успіху. Ми можемо зрозуміти, що наша конверсія більша за \(57\%\). А інформація з двостороннього інтервалу про те, що ймовірність менша за \(88\%\) не додає нам користі.
Навіщо ж ми тоді взагалі використовуємо двосторонній інтервал? Щоб це зрозуміти, подивимося, як виглядають візуально межі для одностороннього інтервалу.
Рисунок 2.6: Односторонній довірчий інтервал для \(22\) успіхів
Порівняно з Рисунок 2.5 ми бачимо, що права критична область стала більшою через те, що там тепер знаходиться не \(2.5\%\), а \(5\%\) від усіх значень. При цьому лівої критичної області просто не існує, тому за великих \(\mu\) не відбувається потрапляння \(19\) до неї, а значить ми не відкидаємо гіпотезу.
Зауважимо, що якби ми будували двосторонній інтервал, але з удвічі більшою \(\alpha\), потрапляння в праву критичну область траплялися б за тих самих \(\mu\), що й в односторонньому критерії. Тому часто для пошуку односторонньої межі будують двосторонній довірчий інтервал із більшою \(\alpha\), ігноруючи при цьому праву межу. Це зручно, оскільки можна користуватися тільки однією функцією для критерію.
Бачимо, що отримали таку саму ліву межу, як і в односторонньому інтервалі.
2.6 Властивості довірчих інтервалів
Згадаймо визначення довірчого інтервалу.
Нехай є критерій \(S = \{Q(\xi) \leqslant C\}\) рівня значущості \(\alpha\) для перевірки гіпотези \({H}_0: \mu = \mu_0\), \(Q\) — статистика критерію, а \(q\) — її реалізація на конкретній вибірці \(\xi = \xi_1, \dots, \xi_n\). Тоді довірчим інтервалом називається множина таких \(\mu_0\), на яких критерій \(S\) не відкидає гіпотезу \({H}_0: \mu = \mu_0\).
Процедура підрахунку інтервалу — це довгий перебір значень із деяким кроком. Але це все ще залишається деякою функцією від вибірки, тобто статистикою й випадковою величиною, причому її розподіл залежить від статистики \(Q\), а отже, і від початкової вибірки, та від параметра \(\mu\) у генеральній сукупності.
Позначимо межі інтервалу за \(\mathcal{L}(Q), \mathcal{R}(Q)\) — статистики критерію, які відповідають лівій та правій межі інтервалу.
2.6.1 Ймовірність попадання в інтервал
Яким би не було істинне значення \(\mu = \mu_0\), ймовірність того, що воно перебуває між \(\mathcal{L}(Q)\) та \(\mathcal{R}(Q)\), не нижча, ніж \(1 - \alpha\). Значення \(1 - \alpha\) називається рівнем довіри довірчого інтервалу.
Важливо, що випадковість тут прихована саме в \(\mathcal{L}\) і \(\mathcal{R}\), а не в \(\mu_0\). Параметр \(\mu_0\) невідомий, але ми припускаємо його константним і не випадковим.
Перевіримо справедливість цієї властивості. Для цього зафіксуємо \(\mu_0\) й проведемо множину експериментів:
Генеруємо вибірку з розподілу з параметром \(\mu_0\).
Обчислюємо статистику \(q\).
Рахуємо довірчий інтервал для \(\alpha = 0.05\).
Перевіряємо, що частка випадків, коли параметр \(\mu_0\) опинився всередині інтервалу, хоча б \(95\%\).
1import time2start_time = time.time()3def my_binomial_confint(n, alpha, q):""" Функція, що обчислює довірчий інтервал для біноміального розподілу n: розмір вибірки alpha: рівень значущості q: кількість успіхів """4 mu_grid = np.arange(0, 1.1, 0.1) # np.arange(0, 1.001, 0.001)5 mu_no_rejection = []6for mu_h0 in mu_grid:7 c1, c2 = two_sided_criterion_nonsym(30, mu_h0, alpha=0.05)8if q > c1 and q < c2:9 mu_no_rejection.append(mu_h0)10returnmin(mu_no_rejection), max(mu_no_rejection)
1
Імпортуємо бібліотеку для вимірювання часу
2
Запускаємо таймер
3
Функція, що обчислює довірчий інтервал
4
Сітка для \(\mu\)
5
Список для значень \(\mu\), для яких \({H}_0\) не відкидається
6
Перебираємо значення \(\mu\) та осі
7
Обчислюємо критичні значення
8
Чи потрапляє \(q\) у критичну область
9
Додаємо значення \(\mu\), для яких \({H}_0\) не відкидається
10
Повертаємо межі довірчого інтервалу
Тепер запустимо експеримент. Для цього зафіксуємо \(\mu_0 = 0.5\) й проведемо \(1000\) експериментів. У кожному з них будемо генерувати \(30\) успіхів, а потім перевіряти, чи потрапила \(\mu_0\) у довірчий інтервал.
Перевіряємо, чи потрапила \(\mu_0\) у довірчий інтервал
10
Обчислюємо частку успішних випадків
11
Вимірюємо час виконання
Відсоток успішних випадків: 61.40%
Час виконання: 3.5347 секунди
Зазначимо, що цей код працював понад 5 хвилин. Це через те, що під час кожного експерименту потрібно побудувати довірчий інтервал, а значить перевірити 1000 можливих параметрів \(\mu_0\).
Бачимо, що властивість виконалася. Ми очікували хоча б \(95\%\) влучень, отримали навіть \(61.4\%\). Насправді це значно більше, ніж ми очікували. Це відбувається через дискретність розподілу. З тієї ж причини під час пошуку критичної області ми не могли вибрати стовпці із сумарною висотою рівно \(\alpha\).
2.6.1.1 Доведення
Під час формулювання властивості ми припускаємо, що є деяка \(\mu_0\) — ймовірність успіху в генеральній сукупності. Коли ми проводимо штучний експеримент, ми фіксуємо її й можемо вважати істинною \(\mu\).
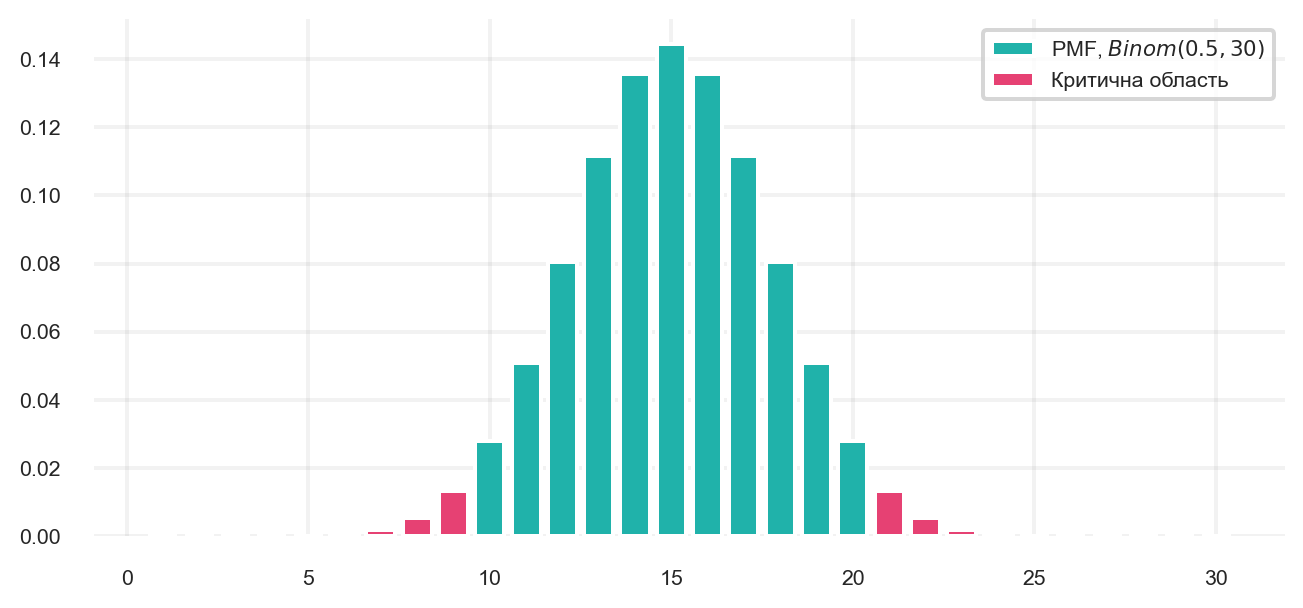
Щоразу ми генеруємо \(Q \sim Binom(\mu_0, 30)\) й перевіряємо, чи потрапила \(\mu_0\) у довірчий інтервал. Намалюємо розподіл статистики \(Q\), який уже нам знайомий. Намалюємо й область ймовірності \(\leqslant \alpha\), як ми робили це раніше.
Рисунок 2.7: Розподіл статистики при істинній ймовірності успіху
Нехай реалізувалося значення статистики \(q\). За такою вибіркою можна побудувати довірчий інтервал на \(\mu\). Він буде якось розташований, але зараз нас цікавить, чи потрапить у нього \(\mu_0\). За визначенням потрапляння в інтервал відбудеться, якщо не відкидається гіпотеза \({H}_0:\ \mu = \mu_0\). Але тоді за справедливості \({H}_0\) статистика має той розподіл, що і на малюнку. І гіпотеза відкидається тільки в разі потрапляння в критичну область, а це трапляється з ймовірністю \(\leqslant \alpha\).
Отже, з ймовірністю хоча б \(1 - \alpha\)\(\mu_0\) перебуватиме в довірчому інтервалі.
Часто так й вводять визначення довірчого інтервалу. Для вибірки \(\xi_1, \dots, \xi_n\) — це така пара статистик \(\mathcal{L}(\xi)\) і \(\mathcal{R}(\xi)\), що хоч яким би не було \(\mu_0\),
де \(L(\xi)\) і \(R(\xi)\) — статистики, що залежать від вибірки. Знову звертаємо увагу, що випадковість тут прихована не в параметрі \(\mu_0\), а в статистиках від вибірки.
2.6.2 Довірчий інтервал Вілсона
Розглянутий зараз алгоритм побудови довірчого інтервалу працює занадто довго. У Python є функції, які дозволяють швидше розрахувати інтервал. Наприклад, можна скористатися методом Вілсона і функцією proportion_confint (Wilson (1927), Statsmodels development team (2023)).
Повторимо експерименти з новим типом довірчого інтервалу, тут можемо дозволити більше реалізацій вибірки, оскільки інтервал рахується недовго.
Відсоток успішних випадків: 96.60%
Час виконання: 0.0704 секунди
Зауважимо, що наше \(\mu\) може знаходитись в довірчому інтервалі менше, ніж у \(95\%\) випадків. Це відбувається через те, що швидкі методи працюють наближено, оцінюючи розподіл статистики при збільшенні розміру вибірки. Чим розмір вибірки більший, тим ближчим буде інтервал до \(95\%\)-ного.
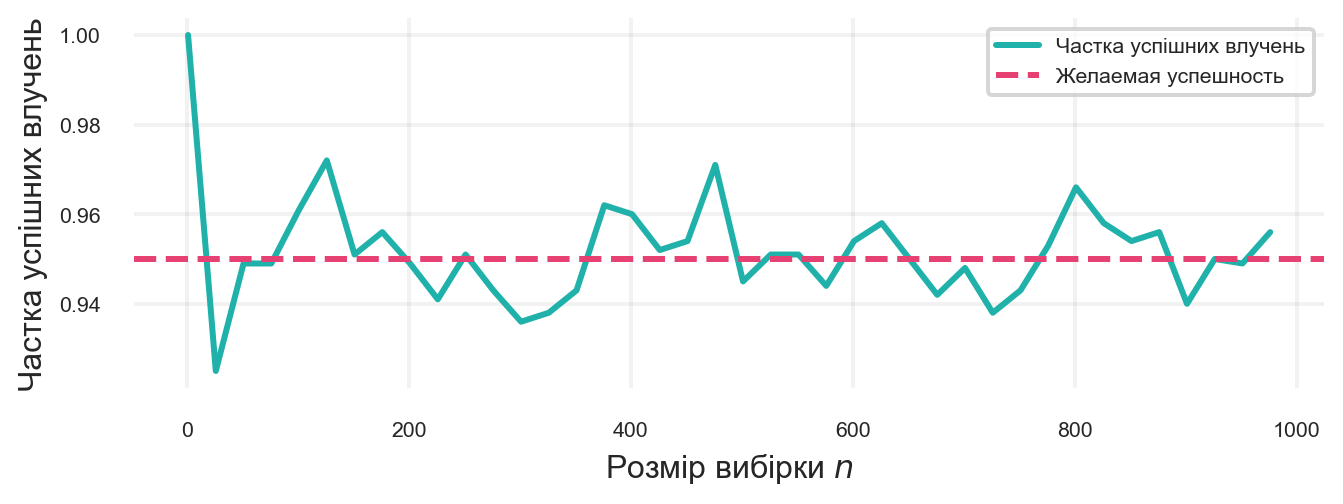
Залежність частки успішних влучень \(\mu\) у довірчий інтервал від розміру вибірки зобразимо на Рисунок 2.8.
1n_grid = np.arange(1, 1000, 25).tolist()2interval_success_rate = []3for n in n_grid:4 confint_fail_cases =05for i inrange(N_EXPERIMENTS):6 binom_true = binom(n=n, p=latent_mu)7 q = binom_true.rvs()8 L, R = proportion_confint( count=q, nobs=n, alpha=0.05, method='wilson' )9if L < latent_mu < R:passelse: confint_fail_cases +=110 interval_success_rate.append(1- confint_fail_cases / N_EXPERIMENTS)
1
Сітка для розміру вибірки
2
Список для частки успішних влучень
3
Перебираємо розміри вибірки
4
Лічильник невдалих випадків
5
Перебираємо експерименти
6
Генеруємо вибірку
7
Генеруємо \(q\) з розподілу
8
Обчислюємо довірчий інтервал
9
Перевіряємо, чи потрапила \(\mu_0\) у довірчий інтервал
Рисунок 2.8: Залежність частки успішних влучень \(\mu\) у довірчий інтервал від розміру вибірки
Видно, що на будь-якому розмірі вибірки під час використання інтервалу Вілсона можна отримати менше \(95\%\) влучень, але що більший розмір вибірки, то менше графік відхиляється від \(95\%\).
2.7 Питання для самоперевірки
Загальні поняття та Помилки
Які два основні типи помилок можна зробити при перевірці статистичних гіпотез? Назвіть їх (FPR та FNR) та поясніть, що кожна з них означає.
Як рівень значущості (\(\alpha\)) пов’язаний з одним із типів помилок?
Поясніть на прикладі “критерію пори року”, чому критерій з низьким рівнем значущості (\(\alpha\)) не обов’язково є хорошим чи корисним.
Статистична Потужність
Що таке статистична потужність критерію? Як вона пов’язана з хибно негативною помилкою (FNR)?
Чому в статистиці часто фокусуються на максимізації потужності (або мінімізації FNR) при фіксованому рівні значущості \(\alpha\)?
Від яких основних факторів залежить потужність статистичного критерію? Як кожен з них (розмір вибірки, величина ефекту, рівень значущості) впливає на потужність?
Як змінюється потужність критерію для біноміального розподілу при збільшенні розміру вибірки (N)? Наведіть приклад з тексту.
Як змінюється потужність критерію для біноміального розподілу при збільшенні різниці між параметром нульової гіпотези (\(\mu_0\)) та параметром альтернативної гіпотези (\(\mu_{alternative}\))? Наведіть приклад з тексту.
Яке значення потужності часто вважається прийнятним мінімальним рівнем у практичних дослідженнях?
Мінімальна Величина Ефекту (MDE)
Що таке Мінімальна величина ефекту, яку можна задетектувати (MDE)?
Як MDE пов’язаний з потужністю, розміром вибірки та рівнем значущості?
Чому важливо розраховувати MDE перед початком експерименту?
Поясніть різницю між статистичною значущістю та практичною значущістю ефекту. Чому ця різниця важлива?
Довірчі Інтервали (ДІ)
Дайте визначення довірчого інтервалу рівня \(1 - \alpha\). Як він пов’язаний з перевіркою гіпотез?
Опишіть основний принцип побудови довірчого інтервалу, який використовувався в тексті для біноміального розподілу (через перебір значень \(\mu_0\)).
Чим відрізняються двосторонні та односторонні довірчі інтервали? В якій ситуації може бути доцільніше використовувати односторонній ДІ?
Як межа одностороннього довірчого інтервалу пов’язана з межами двостороннього довірчого інтервалу, побудованого з подвоєним рівнем значущості (наприклад, \(\alpha=0.1\) для 95% одностороннього інтервалу)?
Поясніть ключову властивість довірчого інтервалу: \(P(\mathcal{L}(Q) < \mu_0 < \mathcal{R}(Q)) \geqslant 1 - \alpha\). Що є випадковим у цій нерівності (параметр \(\mu_0\) чи межі інтервалу \(\mathcal{L}, \mathcal{R}\))?
Чому при використанні точних методів побудови ДІ для дискретних розподілів (як біноміальний) фактична ймовірність покриття істинного параметра може бути більшою за \(1 - \alpha\)?
Які переваги та недоліки використання наближених методів побудови ДІ, таких як метод Вілсона? Коли їх використання виправдане?
2.8 Рекомендована література
Концепції статистичної потужності, величини ефекту та довірчих інтервалів є ключовими для планування та інтерпретації експериментів. Для їх детального вивчення варто опрацювати:
Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences. Класична і найвпливовіша праця з аналізу статистичної потужності. Є вичерпним довідником для розуміння зв’язку між розміром ефекту, розміром вибірки, рівнем значущості та потужністю.
Newcombe, R. G. (2012). Confidence Intervals for Proportions and Related Measures of Effect Size. Спеціалізована книга, що детально розглядає методи побудови довірчих інтервалів для біноміальних пропорцій, включно з методом Вілсона, згаданим у посібнику.
Bruce, P., Bruce, A., & Gedeck, P. (2020). Practical Statistics for Data Scientists. Сучасний посібник, що пояснює концепції потужності, p-значення та довірчих інтервалів з точки зору практичного застосування в A/B-тестуванні та аналізі даних.
Жлуктенко, В. І., & Наконечний, С. І. (2001). Теорія ймовірностей і математична статистика… Ч. II. Український навчальний посібник, який допоможе розібратися з теоретичними основами довірчого оцінювання та перевірки гіпотез у вітчизняній термінології.
Agresti, Alan. 2012. Categorical Data Analysis. 3rd ed. Wiley.
———. 2018. An Introduction to Categorical Data Analysis. 3rd ed. Wiley.
Basu, D. 1955. “On Statistics Independent of a Complete Sufficient Statistic.”Sankhya 15: 377–80.
Bruce, Peter, Andrew Bruce, and Peter Gedeck. 2020. Practical Statistics for Data Scientists. 2nd ed. O’Reilly Media.
Casella, George, and Roger L. Berger. 2002. Statistical Inference. 2nd ed. Duxbury Press.
Cochran, William G. 1934. “The Distribution of Quadratic Forms in a Normal System, with Applications to the Analysis of Covariance.”Mathematical Proceedings of the Cambridge Philosophical Society 30 (3): 178–91. https://doi.org/10.1017/S0305004100016595.
Cohen, Jacob. 1988. Statistical Power Analysis for the Behavioral Sciences. 2nd ed. Lawrence Erlbaum Associates.
Efron, Bradley, and Robert J. Tibshirani. 1993. An Introduction to the Bootstrap. Chapman; Hall/CRC.
Fisher, R. A. 1922. “On the Mathematical Foundations of Theoretical Statistics.”Philosophical Transactions of the Royal Society of London. Series A 222 (594-604): 309–68. https://doi.org/10.1098/rsta.1922.0009.
Freedman, David, Robert Pisani, and Roger Purves. 2007. Statistics. 4th ed. W. W. Norton & Company.
Gnedenko, Boris V., and Alexander N. Kolmogorov. 2021. Limit Distributions for Sums of Independent Random Variables. Martino Fine Books.
Grus, Joel. 2019. Data Science from Scratch: First Principles with Python. 2nd ed. O’Reilly Media.
Haslwanter, Thomas. 2016. An Introduction to Statistics with Python: With Applications in the Life Sciences. Springer.
Hogg, Robert V., Joseph W. McKean, and Allen T. Craig. 2018. Introduction to Mathematical Statistics. 8th ed. Pearson.
Hogg, Robert V., Elliott A. Tanis, and Dale L. Zimmerman. 2015. Probability and Statistical Inference. 9th ed. Pearson.
Lehmann, Erich L., and Joseph P. Romano. 2005. Testing Statistical Hypotheses. 3rd ed. Springer.
Lemons, Don S. 2002. An Introduction to Stochastic Processes in Physics. The Johns Hopkins University Press.
McKinney, Wes. 2022. Python for Data Analysis. 3rd ed. O’Reilly Media.
Montgomery, Douglas C. 2017. Design and Analysis of Experiments. 9th ed. Wiley.
Mood, Alexander M., Franklin A. Graybill, and Duane C. Boes. 1974. Introduction to the Theory of Statistics. 3rd ed. McGraw-Hill.
Newcombe, Robert G. 2012. Confidence Intervals for Proportions and Related Measures of Effect Size. Chapman; Hall/CRC.
Neyman, J., and E. S. Pearson. 1933. “On the Problem of the Most Efficient Tests of Statistical Hypotheses.”Philosophical Transactions of the Royal Society of London. Series A 231 (694-706): 289–337. https://doi.org/10.1098/rsta.1933.0009.
Wasserman, Larry. 2004. All of Statistics: A Concise Course in Statistical Inference. New York: Springer.
Welch, B. L. 1947. “The Generalization of ’Student’s’ Problem When Several Different Population Variances Are Involved.”Biometrika 34 (1-2): 28–35. https://doi.org/10.1093/biomet/34.1-2.28.
Wilson, Edwin B. 1927. “Probable Inference, the Law of Succession, and Statistical Inference.”Journal of the American Statistical Association 22 (158): 209–12. https://doi.org/10.1080/01621459.1927.10502953.
Жлуктенко, В. І., and С. І. Наконечний. 2001. Теорія Ймовірностей і Математична Статистика: Навч.-Метод. Посібник. У 2 ч. Ч. II. Математична Статистика. Київ: КНЕУ.
Турчин, В. М. 2014. Теорія Ймовірностей і Математична Статистика. Основні Поняття, Приклади, Задачі. Дніпропетровськ: ІМА-прес.