5  Монте-Карло в задачах статистики

У цій частині ми розглянемо метод Монте-Карло, який є потужним інструментом для чисельного моделювання та статистичного аналізу. Метод Монте-Карло дозволяє оцінювати ймовірності, інтеграли та інші статистичні характеристики шляхом випадкового вибору з певного розподілу (Robert and Casella (2004)). Ключовим моментом, на котрому ми зупинимось, це пошук відповідей на питання:

5.1 Перевірка критерію

За допомогою методу Монте-Карло ми в загальному випадку зможемо відповісти на запитання:

  • Чи можна використовувати цей критерій для нашого завдання?
  • Чи правильно взагалі реалізовано критерій?

Увесь цей розділ насамперед буде присвячено AB-тестам і як можна перевіряти критерії для них. Основним критерієм для перевірки в цьому розділі стане \(t\)-тест, оскільки навколо нього обертається доволі багато міфів та непорозумінь. Ми з вами:

  • Покажемо на практиці, що \(t\)-тест працює для вибірок не тільки з нормального розподілу.
  • Подивимося, як визначити, з якого розміру вибірки можна застосовувати \(t\)-тест.

Як ми пам’ятаємо з минулої глави (див. 4), \(t\)-тест працює теоретично для вибірок з будь-якого розподілу, якщо вибірка досить велика. Але що значить, що критерій “коректний”? Давайте підемо від визначення:

  • Критерій рівня значущості \(\alpha\) означає, що ймовірність невірно відкинути нульову гіпотезу \(\le \alpha\).
  • А це зі свого боку означає, що якщо нескінченно багато разів повторити один й той самий експеримент, у якому правильна нульова гіпотеза, генеруючи наново експеримент, то кількість хибнопозитивних спрацьовувань буде меншою за \(\alpha\) відсотків.

Ці визначення дозволяють нам визначити процедуру перевірки критерію:

  1. Створюємо код критерію, який ми будемо перевіряти.
  2. Генеруємо якомога більше експериментів, де вірна \(H_0\).
  3. Досліджуємо на них придуманий критерій.
  4. Перевіряємо, чи правда, що тільки в \(\alpha\) відсотків випадків критерій відкидається?

Тепер давайте розглянемо процедуру більш детально:

  1. Насамперед треба вибрати розподіл, який буде описувати наші дані. Наприклад, якщо у нас метрика конверсії, то це розподіл Бернуллі, а якщо метрика — виторг, то краще використовувати експоненціальний розподіл як найпростіше наближення.
  2. Завести лічильник bad_cnt, який буде рахувати кількість разів, коли критерій помилився. Ініціалізувати його нулем.
  3. Далі в циклі розміру \(N\), де \(N\) — натуральне число від 1000 до нескінченності (чим воно більше, тим краще):
    • Симулюємо створення вибірки з розподілу, обраного на першому кроці. Так, щоб вірною була \(H_0\). У випадку AB-тесту симулювати треба не одну вибірку, а дві: для тесту і контролю.
    • Досліджуємо на згенерованих даних критерій, що перевіряється.
    • Далі перевірити, чи критерій відкинув нульову гіпотезу. Якщо так, то збільшуємо bad_cnt на одиницю.
  4. Порахувати частку помилок. Це буде ймовірність того, що критерій помиляється.
    • Якщо вона приблизно збігається з \(\alpha\), то все добре.
    • Якщо вона менша за \(\alpha\), то в принципі це адекватний критерій на практиці, просто він буде менш потужний, ніж критерій, що помиляється рівно у \(\alpha\) відсотку випадків. Але на практиці варто перевірити: а теоретично така ситуація можлива? Чи це помилка в коді критерію?
    • Якщо критерій помиляється більше, ніж у \(\alpha\), то значить він некоректний і ним не можна користуватися. Використовуючи такий критерій, ви будете помилятися частіше, ніж треба, і це може призвести до серйозних помилок у бізнес-рішеннях.

Розглянемо процедуру на прикладі: перевіримо, чи можна використовувати \(t\)-тест для вибірок із нормального розподілу?


np.random.seed(42)

bad_cnt = 0
N = 10000
alpha = 0.05

sample_dist = norm(loc=2, scale=3)
mu0=sample_dist.expect()
for i in range(N):
    test    = sample_dist.rvs(5)
    control = sample_dist.rvs(5)
    pvalue = ttest_ind(test, control, alternative='two-sided').pvalue
    bad_cnt += (pvalue < alpha)

print(f"FPR: {bad_cnt/N:.3f}")
FPR: 0.052


Зверніть увагу, що \(FPR=\) 0.052, хоча він мав дорівнювати 5%. Чи правда, що критерій некоректний? Ні, ми просто не врахували шум: ми навряд чи зможемо отримати на кінцевому числі експериментів точну рівність \(\text{FPR} = \alpha\).

Тому пункт 4 процедури перевірки критерію можна уточнити:

  1. Порахувати частку помилок й побудувати довірчий інтервал для нього. Якщо \(\alpha\) лежить у ньому, значить усе добре, а інакше розбираємося, що пішло не так.

Довірчий інтервал можна побудувати різними способами (див. 2.4). Але можна зробити простіше: у Python є функція, яка будує довірчий інтервал Вілсона1: він не такий точний, як ми виводили раніше, зате він швидший й працює швидше. Давайте спробуємо його реалізувати:


ci = proportion_confint(count = bad_cnt, nobs = N, alpha=0.05, method='wilson')
print(f"FPR: {bad_cnt/N:.3f}\nДовірчий інтервал: ({ci[0]:.3f}, {ci[1]:.3f})")
FPR: 0.052
Довірчий інтервал: (0.048, 0.056)


Як бачимо, що 5% потрапили в довірчий інтервал, а отже, ми можемо вважати, що критерій є валідним для нашого завдання.

А що, якби розподіл був складнішим?

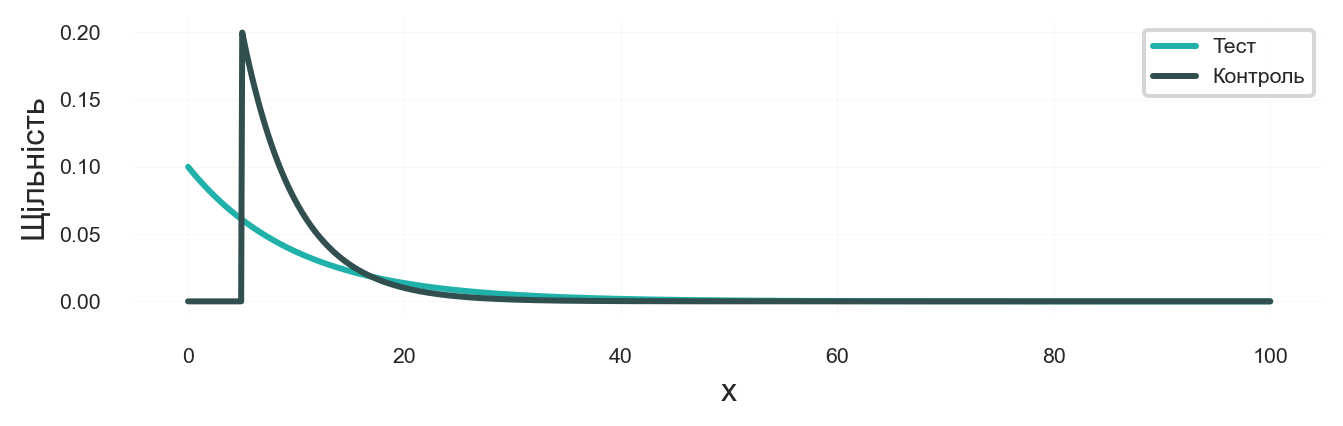
Розглянемо приклад, коли магматичне сподівання в тесті й контролі рівні, але вибірки з різних розподілів. Тобто \(H_0\) правильна, але розподіли різні. Для цього ми можемо взяти два експоненціальних розподіли з різними параметрами. Наприклад, раніше в середньому виручка від користувача була приблизно 10 гривень, а після введення ефекту впливу (нове ціноутворення) частина користувачів стала менше платити, але середній чек залишився таким самим: 10 гривень.


np.random.seed(42)

test_dist = expon(scale = 10)
control_dist = expon(loc=5, scale = 5)

x = np.linspace(0, 100, 1000)

fig, ax = plt.subplots(figsize=(8, 2))
plt.plot(x, test_dist.pdf(x), label='Тест', color=turquoise)
plt.plot(x, control_dist.pdf(x), label='Контроль', color=slate)
plt.xlabel('x')
plt.ylabel('Щільність')
plt.legend()
plt.grid(linewidth=0.2)
plt.show()
Рисунок 5.1: Приклад, коли \(H_0\) правильна, але розподіли різні

Напишемо функцію check_criterion(), яка буде перевіряти критерій на коректність. Вона приймає на вхід розподіли для тесту й контролю, розмір вибірки, кількість експериментів, а також вміє виводити довірчий інтервал.


def check_criterion(
    test_dist,
    control_dist, 
    sample_size, 
    N_exps=10000, 
    to_print=True
):
    """
    Функція перевіряє критерій на коректність.
    test_dist: розподіл для тесту
    control_dist: розподіл для контролю
    sample_size: розмір вибірки
    N_exps: кількість експериментів
    to_print: чи виводити довірчий інтервал
    """
    np.random.seed(35)
    bad_cnt=0
    alpha=0.05

    for i in range(N_exps):
        test    = test_dist.rvs(sample_size)
        control = control_dist.rvs(sample_size)
        pvalue = ttest_ind(test, control, equal_var=False,
                           alternative='two-sided').pvalue
        bad_cnt += (pvalue < alpha)

    ci = proportion_confint(count = bad_cnt, nobs = N_exps,
                            alpha=0.05, method='wilson')

    if to_print:
        print(f"FPR: {bad_cnt/N_exps:.3f}")
        print(f"Довірчий інтервал: ({ci[0]:.3f}, {ci[1]:.3f})")
    else:
        return ci


Тепер перевіримо, чи працює \(t\)-тест для вибірок з різних експоненціальних розподілів. Одразу спробуємо перевірити відомий міф про достатність вибірки 302. Чи дійсно \(t\)-тест працює, якщо вибірка більша за 30?


check_criterion(test_dist, control_dist, sample_size=40)
FPR: 0.061
Довірчий інтервал: (0.057, 0.066)


Як бачимо, \(t\)-тест не спрацював, хоча вибірка більша за 30. Істинне \(\alpha\) не лежить у довірчому інтервалі. Але з якого розміру вибірки \(t\)-тест почне працювати правильно?

5.2 Визначення розміру вибірки

Визначити розмір вибірки, з якого \(t\)-тест почне працювати, можна за допомогою методу Монте-Карло. Для цього ми будемо перевіряти \(t\)-тест на вибірках різного розміру, поки не знайдемо такий розмір, при якому \(t\)-тест почне працювати. Для цього ми будемо перевіряти \(t\)-тест на вибірках від 20 до 100 з кроком 10.


scale = np.arange(20, 110, 10)
for N in scale:
    left, right = check_criterion(test_dist=test_dist,
                                  control_dist=control_dist,
                                  sample_size=N, 
                                  N_exps=10000, 
                                  to_print=False)
    if left < alpha < right:
        print(f"Розмір вибірки {N} достатній для t-тесту")
        break
Розмір вибірки 60 достатній для t-тесту


Як бачимо, \(t\)-тест починає працювати з вибірки розміром 60.


check_criterion(test_dist=test_dist, control_dist=control_dist, sample_size=60)
FPR: 0.053
Довірчий інтервал: (0.048, 0.057)


Але це доволі умовна межа, бо якщо у цьому випадку ми візьмемо вибірку розміром 61, то \(t\)-тест не спрацює.


check_criterion(test_dist=test_dist, control_dist=control_dist, sample_size=61)
FPR: 0.057
Довірчий інтервал: (0.052, 0.061)


Це може бути пов’язано з тим, що ми взяли недостатню велику кількість експериментів, або з дисперсією, або з обома факторами. Тому, якщо потрібна більша точність — необхідно проводити більше експериментів.

5.3 Моделювання експерименту

Розберемо два сценарії моделювання експерименту:

  1. Генерація тестової та контрольної групи через імітаційне моделювання. За допомогою різних розподілів можна спробувати наблизити реальний розподіл на даних. Наприклад:
    • Для генерації виручки використовувати експоненціальний розподіл. Чим більша виручка від користувача — тим менше таких людей.
    • Для генерації конверсійних вибірок (наприклад, клікне/не клінкет) використовувати бернулліївську вибірку.
    • Іноді можна брати суміш розподілів: нехай 90% користувачів нашого сайту приносять нульову виручку. Тоді можна перемножити бернуллівський розподіл на експоненціальний для моделювання виручки від користувача.
    • Також для перевірки критерію рівності середніх не обов’язково мають збігатися розподіли в тесті та в контролі. Вони можуть бути різними, але математичне сподівання має збігатися.
  2. Використати історичні дані компанії. У багатьох компаній є логування подій. Тоді ми зможемо прямо на реальних даних оцінити правильність критерію! І не потрапити в пастку того, що на штучних вибірках критерій валідний, а на реальних даних ні. Наприклад, у нас є дані про транзакції користувачів за кілька років. Це вже один готовий набір даних: ви ділите всіх користувачів на тестову та контрольну групи й отримуєте один “експеримент” для перевірки вашого критерію.

Залишилося зрозуміти, як з одного великого набору даних зробити \(N\) маленьких. Покажемо на прикладі сервісу з оголошень: наші користувачі розміщують оголошення, кожне оголошення відноситься тільки до однієї категорії товарів і розміщено тільки в одному регіоні. Звідси виникає нехитрий алгоритм:

  • Розіб’ємо всі оголошення користувачів на чотири (або \(N\) у загальному випадку) категорії: автомобілі, спецтехніка, послуги та нерухомість. Тепер наш набір даних можна розбити на ці підкатегорії: наприклад, в одному наборі даних дивитися виручку користувача тільки в цій підкатегорії.
  • Поділимо набір даних за місяцями: витрат користувача за листопад, за грудень тощо.
  • Ще всі метрики можна поділити за адміністративно-територіальними одиницями: місто, громада, район, область тощо.
  • Об’єднаємо всі три правила в одне. Наприклад: набір даних витрат користувача в сервісі оголошень за жовтень у Києві.
  • Тепер у нас є велика кількість наборів даних і в кожному з них є користувачі. Поділимо користувачів випадково на тест і контроль й отримаємо фінальні набір даних для валідації придуманих статистичних критеріїв.

Якщо порівнювати два підходи, то головні переваги штучних даних у тому, що їх скільки завгодно, вони генеруються швидко, й ви повністю контролюєте розподіл. Можна створити нескінченно багато наборів даних й дуже точно оцінити помилку першого роду вашого критерію. На початкових етапах дослідження нового критерію штучні дані значно кращі за реальні. Головний мінус — ви отримали коректність вашого критерію тільки на штучних даних! На реальних же даних критерій може працювати некоректно.

У наборів даних, отриманих на справжніх даних, усе навпаки: зібрати їх велику кількість складно, та й не завжди нормально побудований процес їх збору. Але адекватна оцінка коректності критерію для перевірки гіпотез у вашій компанії можлива тільки в такий спосіб. Завжди можна реалізувати такий критерій, який буде правильно працювати на штучних даних. Але, зіткнувшись у реальності з більш шумними даними, він може почати помилятися частіше, ніж у 5% випадків. Тому важливо переконатися, що саме на справжніх даних метод працюватиме правильно.

5.4 Додаткові питання

5.4.1 \(t\)-тест та мала вибірка не з нормального розподілу

У попередньому розділі ми розглянули \(t\)-тест для вибірок з нормального розподілу. Розглянемо екстремальний випадок, коли вибірка мала, а розподіл не нормальний. Ми знову використаємо метод Монте-Карло, щоб перевірити, чи працює \(t\)-тест у цьому випадку.


test_dist    = expon(scale=20)
control_dist = expon(scale=20)

check_criterion(test_dist=test_dist, control_dist=control_dist, sample_size=10)
FPR: 0.040
Довірчий інтервал: (0.036, 0.044)


Тут FPR статистично значущо менше 5%, а отже, використовувати \(t\)-тест можна. Тільки треба бути готовим, що він буде не дуже потужним.

5.4.2 Як обрати критерій

Нехай у вас є два критерії, й обидва валідні на наших даних. Як зрозуміти на практиці, який із них кращий?

Правильна відповідь — треба порівняти потужність 2 критеріїв! Але як її дізнатися?

Пропонується повторити ту саму процедуру, що ми робили вище, тільки замість генерації експерименту, коли вірна \(H_0\), генерувати експеримент, коли вірна альтернатива. У разі порівняння середніх — треба додати ефект до тесту. І замість FPR рахувати TPR — частка правильно відхилених нульових гіпотез. Чим більше — тим краще.

Перевіримо на прикладі \(t\)-тесту, як це працює.


rej_cnt = 0
N = 10000
alpha=0.05

sample_dist = norm(loc=2, scale=3)
mu=sample_dist.expect()

for i in range(N):
    test    = sample_dist.rvs(15)
    control = sample_dist.rvs(15) * 2
    pvalue = ttest_ind(test, control,
                       equal_var=False, alternative='two-sided').pvalue
    rej_cnt += (pvalue < alpha)

print(f"TPR: {rej_cnt/N:.3f}")
TPR: 0.194


Бачимо, що потужність критерію в цьому випадку дорівнює 0.19. Якщо є другий критерій — треба запустити таку перевірку для 2го критерію й оцінити, який критерій кращий чи гірший, не забувши про статичну значущість.

Ще є питання: ви оцінили 2 критерії лише при додаванні одного ефекту, наприклад у випадку вище, коли \(\mu_T = \mu_C \times 2\). А якби була інша зміна, збереглися б результати, що цей критерій кращий? Не факт, тому треба підбирати такий ефект, який найчастіше зустрінеться на практиці. Ваше завдання ще правильно зімітувати ефект, схожий на справжній.

Логіка тут точно така сама, як і чому краще генерувати експерименти на історичних даних, а не на справжніх.

Тобто, ваше завдання для оцінки потужності критерію полягає в:

  1. Створенні 1000 експериментів, на історичних даних, або на симульованих
  2. Підборі ефекту, який буде найкраще імітувати істинний ефект, що перевіряється, в гіпотезі.

5.5 Питання для самоперевірки

Загальні питання про метод Монте-Карло

  1. Що таке метод Монте-Карло в контексті статистики, як описано в цій главі? Яка його основна ідея?
  2. Для відповіді на які три ключові питання автори пропонують використовувати метод Монте-Карло в задачах статистики (особливо AB-тестування)?

Перевірка коректності критерію (FPR)

  1. Опишіть покрокову процедуру перевірки коректності (валідності) статистичного критерію за допомогою методу Монте-Карло, як викладено в розділі “Перевірка критерію”.
  2. Що означає, що критерій є “коректним” з точки зору помилки першого роду (рівня значущості α)? Як це пов’язано з симуляціями, де нульова гіпотеза (\(H_0\)) є істинною?
  3. Чому при перевірці критерію недостатньо просто порівняти отриману частку помилок (FPR - False Positive Rate) з рівнем значущості α? Яку роль відіграє довірчий інтервал і як його інтерпретувати в цьому контексті?
  4. Які висновки можна зробити, якщо обчислений довірчий інтервал для FPR:
    • Містить α?
    • Повністю лежить нижче α?
    • Повністю лежить вище α?
  5. Які приклади розподілів наводяться для симуляції даних для різних типів метрик (конверсії, виторг)?

Визначення розміру вибірки та специфіка t-тесту

  1. Як за допомогою методу Монте-Карло можна визначити мінімальний розмір вибірки, за якого певний критерій (наприклад, t-тест) починає працювати коректно для заданих (можливо, ненормальних) розподілів?
  2. Які поширені уявлення про t-тест (стосовно нормальності даних та розміру вибірки > 30) були перевірені та продемонстровані за допомогою Монте-Карло в цій главі? Які висновки було зроблено?
  3. Чи можна використовувати t-тест, якщо дані не розподілені нормально, особливо при малих вибірках? Який результат показало моделювання для експоненціального розподілу? Який недолік може мати такий тест у цьому випадку?

Моделювання експерименту

  1. Які два основні підходи до моделювання експериментів (генерації даних для перевірки критеріїв) розглядаються в главі?
  2. Назвіть переваги та недоліки використання штучно згенерованих даних (з теоретичних розподілів) для перевірки критеріїв.
  3. Назвіть переваги та недоліки використання історичних (реальних) даних компанії для перевірки критеріїв. Чому перевірка на реальних даних вважається важливою?
  4. Які способи пропонуються для створення множини експериментів з одного великого набору історичних даних?

Вибір між критеріями (Потужність/TPR)

  1. Якщо два статистичні критерії виявилися валідними (тобто коректно контролюють помилку першого роду), як метод Монте-Карло допомагає обрати кращий з них?
  2. Яку характеристику критеріїв потрібно порівнювати для вибору кращого? Як вона називається і що означає? (Підказка: TPR - True Positive Rate)
  3. У чому ключова відмінність процедури Монте-Карло для оцінки потужності критерію від процедури для перевірки його валідності (контролю FPR)?
  4. На що важливо звернути увагу при симуляції ефекту (різниці між групами) для оцінки потужності критерію? Чому це важливо?

  1. Wilson (1927)↩︎

  2. Hogg, Tanis, and Zimmerman (2015)↩︎