meeting_time = np.array([50, 55, 70, 45, 40, 70, 80])
print(f"Середнє значення: {np.mean(meeting_time):.2f} хвилин")
Середнє значення: 58.57 хвилинСпробуємо розв’язати таке завдання.
Приклад 4.1
Менеджмент компанії розглядає новий підхід до планування щотижневих нарад, щоб зменшити втрати часу співробітників. Раніше середня тривалість таких нарад складала 70 хвилин. Ідея полягає в тому, щоб перейти до нової структури нарад, яка, за задумом, дозволить зменшити тривалість нарад до 60 хвилин.
Протягом одного тижня провели 7 нарад у новому форматі й зафіксували їх тривалість. Якщо з’ясується, що нові наради тривають довше, ніж у середньому 70 хвилин, новий формат вважатимуть неефективним.
Ваше завдання — перевірити, чи новий формат нарад дійсно ефективніший.
Вийшла вибірка середньої тривалості нарад (в хвилинах):
[50, 55, 70, 45, 40, 70, 80].
Для початку переформулюємо умову мовою математики. Є вибірка:
meeting_time = np.array([50, 55, 70, 45, 40, 70, 80])
print(f"Середнє значення: {np.mean(meeting_time):.2f} хвилин")Середнє значення: 58.57 хвилин
Наша гіпотеза звучить так:
\[ H_0: E \overline{X} \geq 70 \; \text{проти} \; H_1: E \overline{X} < 70 \]
Здається, що ми таке вже вміємо вирішувати: згадаємо про \(Z\)-критерій:
\[ H_0: \mu \leq \mu_0\ \; \text{проти} \; \ H_1: \mu > \mu_0 \]
Тоді треба лише порахувати таку статистику: \(\sqrt{n}\dfrac{\overline X - 70}{\sqrt{\sigma^2}} \overset{H_0}{\sim} \mathcal{N}(0, 1)\).
Але є суттєва проблема: ми не знаємо \(\sigma^2\)! Тому ми не можемо використовувати \(Z\)-критерій.
Давайте спробуємо оцінити \(\sigma^2\) за допомогою вибірки. Для цього скористаємося формулою:
\[ \hat{\sigma}^2 = S^2 = \dfrac{1}{n - 1} \sum_{i=1}^n (X_i - \overline X)^2 \tag{4.1}\]
Вона називається вибірковою дисперсією. Вибіркова дисперсія є незміщеною та консистентною оцінкою дисперсії генеральної сукупності.
Вибіркова дисперсія є незміщеною, оскільки ми ділимо на \(n - 1\), а не на \(n\). Це робиться для того, щоб уникнути систематичної помилки в оцінці дисперсії. Консистентність пояснюється тим, що з ростом вибірки \(n\) ми все ближче підходимо до істинної дисперсії генеральної сукупності.
Для розрахунку вибіркової дисперсії в Python можна скористатися функцією np.var з параметром ddof=1, що означає, що ми ділимо на \(n - 1\).
meeting_time_var = np.var(meeting_time, ddof=1)
print(f"Вибіркова дисперсія: {meeting_time_var:.2f} хвилин")
Вибіркова дисперсія: 222.62 хвилин
Давайте введемо новий критерій \(t'\)-тест, у якому ми підставимо:
Залишилося перевірити: Чи правда, що при \(H_0\) розподіл \(t\)-статистики — стандартний нормальний?
Для цього пропонується подивитися, як насправді буде розподілена статистика \(t(X) = \sqrt{n}\dfrac{\overline{X}-\mu_0}{\sqrt{S^2}}\) у завданні, яке було поставлено від початку.
Для цього будемо вважати, що вибірка \(X\) складається з 7 елементів й \(X \sim \mathcal{N}\).
Для цього ми напишемо функцію sample_statistics, яка зможе побудувати розподіл для будь-якої статистики, а не тільки для \(t(X), Z(X)\). Вона приймає на вхід:
number_of_experiments — кількість експериментів, які ми хочемо провести;statistic_function — функція, яка обчислює статистику;sample_size — розмір вибірки;sample_distr — розподіл, з якого ми генеруємо вибірку.
def sample_statistics(
    number_of_experiments,
    statistic_function,
    sample_size,
    sample_distr
):
    """
    Генерує вибірку з розподілу та обчислює статистику для кожної вибірки.

    number_of_experiments: кількість експериментів
    statistic_function: функція, яка обчислює статистику
    sample_size: розмір вибірки
    sample_distr: розподіл, з якого генеруємо вибірку
    """
    statistic_sample = []
    for _ in range(number_of_experiments):
        sample = sample_distr.rvs(sample_size)
        statistic = statistic_function(sample)
        statistic_sample.append(statistic)
    return statistic_sample
Тепер перевіримо, чи дійсно \(t(X)\) розподілена нормально. Для цього скористаємося функцією sample_statistics та побудуємо гістограму для \(t(X)\). Генерувати вибірку будемо з нормального розподілу \(\mathcal{N}(5, 3^2)\).
1sample_size = 7
M = 100000
sample_distr = norm(loc=5, scale=3)

2T_X = lambda x: (
    np.sqrt(sample_size) * (np.mean(x) - sample_distr.mean()) /
    np.sqrt(np.var(x, ddof=1))
)

Z_X = lambda x: (
    np.sqrt(sample_size) * (np.mean(x) - sample_distr.mean()) /
    sample_distr.std()
)

3samples = {
    "T(X)": sample_statistics(
    number_of_experiments=M, statistic_function=T_X,
    sample_size=sample_size, sample_distr=sample_distr),

    "Z(X)": sample_statistics(
    number_of_experiments=M, statistic_function=Z_X,
    sample_size=sample_size, sample_distr=sample_distr)
}

4for i, name in enumerate(["T(X)", "Z(X)"]):
    plt.subplot(1, 2, i + 1)
    current_sample = samples[name]
    l_bound, r_bound = np.quantile(current_sample, [0.001, 0.999])

    x = np.linspace(l_bound, r_bound, 1000)
    sns.distplot(current_sample, label='Емпіричний розподіл', color=turquoise)
    plt.plot(x, norm(0, 1).pdf(x), label='$\mathcal{N}(0, 1)$', color=red_pink)
    plt.legend(loc='upper left')
    plt.xlabel(f'{name}')
    plt.xlim((l_bound, r_bound))
    plt.ylabel('Щільність')
    plt.grid(linewidth=0.2)

plt.show()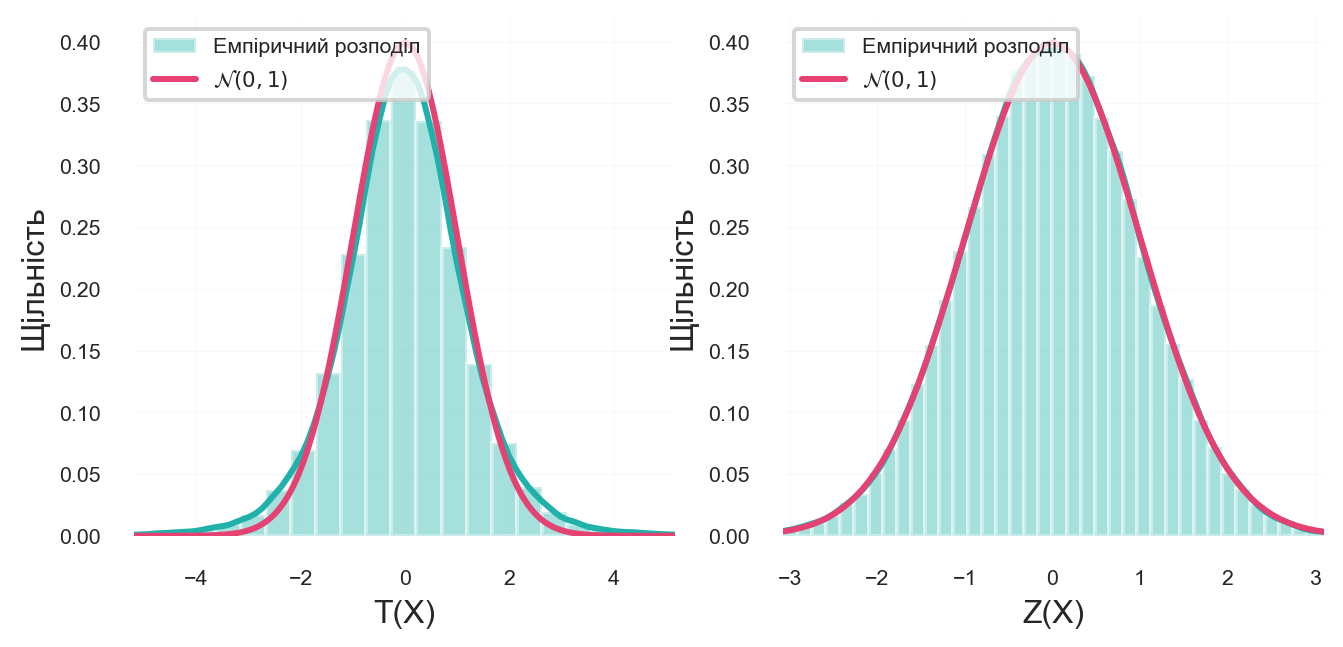
Ми бачимо, що:
Для того щоб стало зрозуміло, чому так сталося, розглянемо \(t(X)\) у деталях. При створенні критерію є два кроки:
Але чому \(t(X) = \sqrt{n}\dfrac{\overline X - \mu}{\sqrt{S^2}}\) не розподілена нормально, хоча \(\sqrt{n}\dfrac{\overline X - \mu}{\sqrt{\sigma^2}} \overset{H_0}{\sim} \mathcal{N}(0, 1)\)$? Чому при заміні \(\sigma^2\) на \(S^2\) усе зіпсувалося?
Справа в тому, що \(S^2\) — це випадкова величина! Згадаймо, як ми виводили \(Z\)-критерій:
Але ми нічого не знаємо про \(\dfrac{\overline{X}}{\sqrt{\eta}}\), де \(\overline{X} \sim \mathcal{N}, S^2 := \eta \sim P\), де \(P\) невідомо. Ми не знаємо поки що жодних теорем, які б хоч якось доводили, що тут також залишиться нормальний розподіл.
Давайте подивимося на розподіл \(\sqrt{S^2}\) на все тому ж нормальному розподілі.
1S2 = lambda sample: np.std(sample, ddof=1)
2S2_sample = sample_statistics(
    number_of_experiments=M, statistic_function=S2,
    sample_size=sample_size, sample_distr=sample_distr
)

sns.distplot(S2_sample, label='Емпіричний розподіл', color=turquoise)
plt.legend()
plt.xlabel('$\sqrt{S^2}$')
plt.ylabel('Щільність')
plt.grid(linewidth=0.2)
plt.show()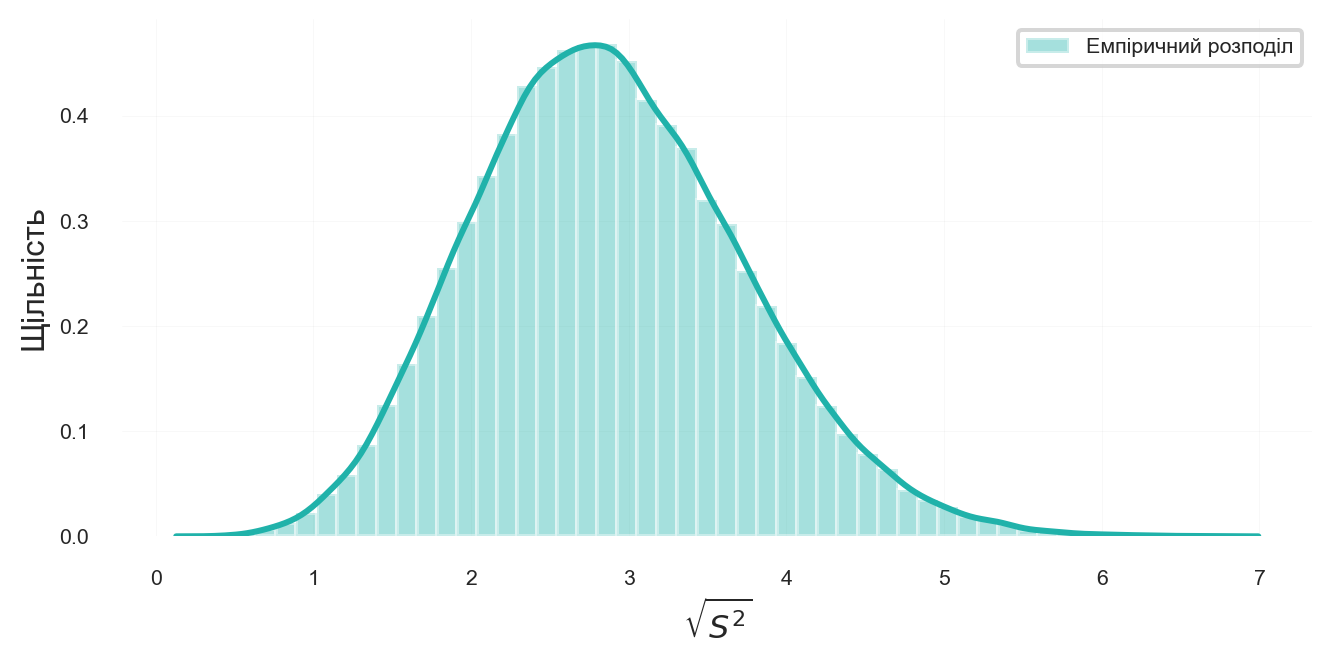
Розподіл \(\sqrt{S^2}\) несиметричний й незрозуміло як розподілений. Тому, коли ми якусь величину з нормального розподілу ділимо на несиметричний незрозумілий розподіл, ми й отримуємо, що наша статистика \(t\) не з нормального розподілу.
Тож давайте виведемо критерій, який допоможе розв’язати початкову задачу (Student (1908))!
Для того щоб вивести \(t\)-тест, нам потрібно зрозуміти, як розподіляється статистика \(t(X) = \sqrt{n}\dfrac{\overline X - \mu_0}{\sqrt{S^2}}\). Для того, щоб це дізнатися, нам знадобиться кілька фактів:
Тоді \(\underset{i=1}{\overset{n}{\sum}}\left(\xi_i - \overline \xi \right)^2 \sim \chi^2_{n-1}\) 2.
\(S^2_X = \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}}(X_i - \overline X)^2\)
\(\xi_i := \dfrac{X_i - \mu}{\sigma} \sim \mathcal{N}(0, 1)\). Тоді \[\begin{aligned} S^2_{\xi} &= \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}}\left(\xi_i - \overline \xi \right)^2 = \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}} \left(\dfrac{X_i-\mu}{\sigma} - \underset{i=1}{\overset{n}{\sum}}\left[\dfrac{X_i-\mu}{n\sigma}\right] \right)^2 = \\ &= \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}} \left(\dfrac{X_i}{\sigma} - \dfrac{\mu}{\sigma} - \underset{i=1}{\overset{n}{\sum}}\left[\dfrac{X_i}{n\sigma}\right] + \dfrac{n\mu}{n\sigma} \right)^2 =\\ &= \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}} \left(\dfrac{X_i}{\sigma} -\dfrac{\overline X_i}{\sigma} \right)^2 = \dfrac{1}{\sigma \cdot(n - 1)}\underset{i=1}{\overset{n}{\sum}} \left(X_i - \overline X_i \right)^2 = \dfrac{1}{\sigma}S^2_X \end{aligned} \]
А значить \(\dfrac{(n - 1)\cdot S^2_X}{\sigma^2} = \underset{i=1}{\overset{n}{\sum}}\left(\xi_i - \overline \xi \right)^2 \sim \chi^2_{n-1}\)
У підсумку, статистика \(t = \sqrt{n}\dfrac{\overline X - \mu_0}{\sqrt{S^2}} \sim t_{n - 1}\) — взята з розподілу Стьюдента з \(n - 1\) ступенем свободи. Але тільки в разі, якщо початкова вибірка з нормального розподілу!
Тепер нам достатньо даних, щоб побудувати \(t\)-тест:
\[ H_0: \mu =\mu_0, \ X \sim \mathcal{N}\ проти\ H_1: \mu > \mu_0 \tag{4.2}\]
Статистика \(t(X)\) буде виглядати так:
\[ t(X) = \sqrt{n}\dfrac{\overline X - \mu_0}{\sqrt{S^2}} \sim t_{n - 1} \tag{4.3}\]
Тоді односторонній критерій набуває вигляду: \[ \left\{t(X) \geq t_{n-1, 1 - \alpha} \right\} \tag{4.4}\]
А \(p\)-значення для одностороннього критерію можна обчислити так:
\[ p\text{-значення} = 1 - \tau_{n-1}(z), \tag{4.5}\] де z — реалізація статистики \(t(X)\), \(\tau_{n-1}(z)\) — функція розподілу \(t_{n - 1}\)
Двосторонній критерій буде виглядати так: \[ \left\{t(X) \geq t_{n-1, 1 - \frac{\alpha}{2}} \right\} \bigcup \left\{t(X) \leq -t_{n-1, 1 - \frac{\alpha}{2}} \right\} \tag{4.6}\]
При цьому \(p\)-значення для двостороннього критерію можна обчислити так:
\[ p\text{-значення} = 2\cdot \min \left[{\tau_{n-1}(z), 1 - \tau_{n-1}(z)} \right], \tag{4.7}\] де \(z\) — реалізація статистики \(t(X)\), \(\tau_{n-1}(z)\) — функція розподілу \(t_{n - 1}\).
Давайте тепер протестуємо всі наші теоретичні дослідження на практиці. Для цього нам знадобляться наступні бібліотеки функції:
scipy.stats.chii2 — для розподілу \(\chi^2\);scipy.stats.t — для \(t\) розподілу Стюдента;scipy.stats.ttest_1samp — для \(t\)-тесту.Подивимось на розподіл \(\chi^2\) та розподіл \(\eta\).
1sample_size = 7
sample_distr = norm(loc=5, scale=3)
sample = sample_distr.rvs(sample_size)
M = 10000

2eta_stat = lambda x: (
    np.var(x, ddof=1) * (sample_size - 1) / sample_distr.var()
)

3eta_sample = sample_statistics(
    number_of_experiments=M,
    statistic_function=eta_stat,
    sample_size=sample_size,
    sample_distr=sample_distr
)

4chi2_dist = chi2(df=sample_size - 1)
5l, r = np.quantile(eta_sample, [0.001, 0.999])

x = np.linspace(l, r, 1000)
sns.distplot(eta_sample, label='Емпіричний розподіл', color=turquoise)
plt.plot(x, chi2_dist.pdf(x), label='$\chi^2$', color=red_pink)

plt.legend()
plt.xlabel('$\eta$')
plt.ylabel('Щільність')
plt.grid(linewidth=0.2)
plt.show()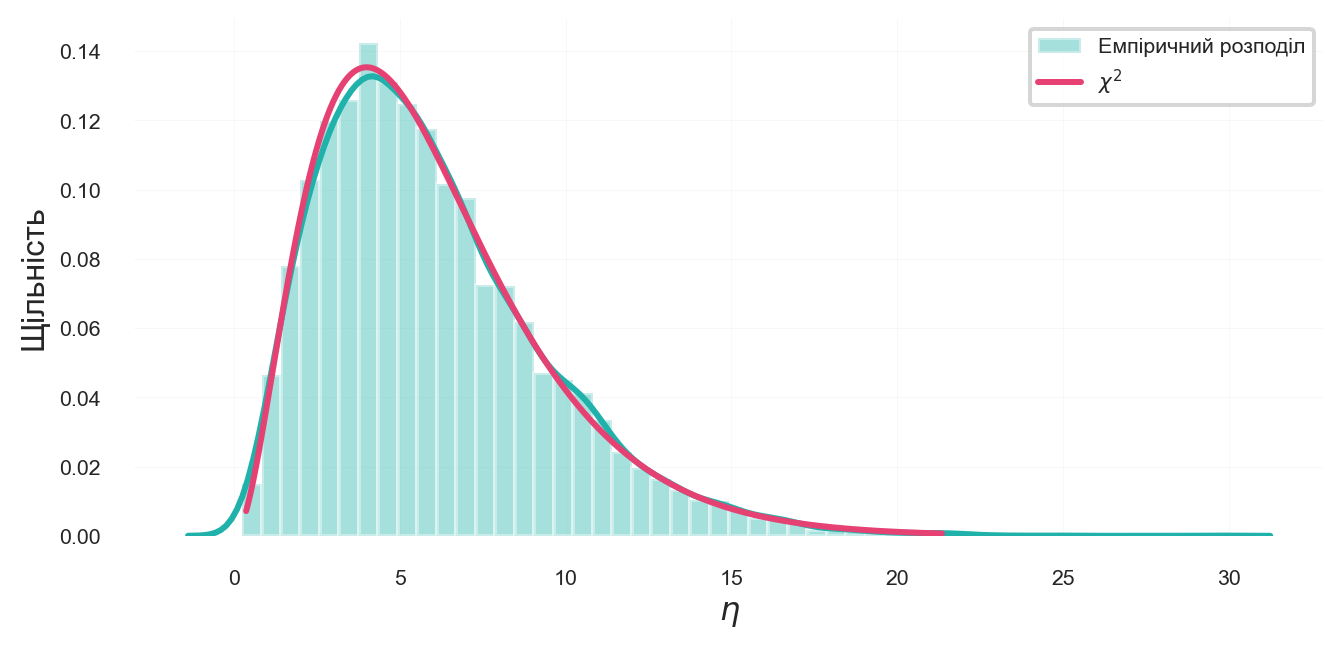
Ми бачимо, що емпіричний розподіл \(\eta\) та теоретичний \(\chi^2\) збігаються. Це означає, що ми можемо використовувати \(t\)-тест для перевірки гіпотези.
Тепер перевіримо, чи дійсно \(t(X)\) описується розподілом Стьюдента. Для цього скористаємося функцією sample_statistics та побудуємо гістограму для \(t(X)\). Генерувати вибірку будемо з нормального розподілу \(\mathcal{N}(5, 3^2)\).
sample_size = 7
sample_distr = norm(loc=5, scale=3)
sample = sample_distr.rvs(sample_size)
M = 10_000

T_X = lambda x: (
    np.sqrt(sample_size) * (np.mean(x) - sample_distr.mean()) /
    np.std(x, ddof=1)
)

T_sample = sample_statistics(
    number_of_experiments=M,
    statistic_function=T_X,
    sample_size=sample_size,
    sample_distr=sample_distr
)

T_dist = t(df=sample_size - 1)
l, r = np.quantile(T_sample, [0.001, 0.999])
x = np.linspace(l, r, 1000)

sns.distplot(T_sample, color=turquoise, label='Емпіричний розподіл')
plt.plot(x, T_dist.pdf(x), c=red_pink, label='$t_{n-1}$')
plt.plot(x, norm(0, 1).pdf(x), c=slate, ls='--', label='$\mathcal{N}(0, 1)$')

plt.legend()
plt.xlabel('$t(X)$')
plt.ylabel('Щільність')
plt.xlim(l, r)
plt.grid(linewidth=0.2)
plt.show()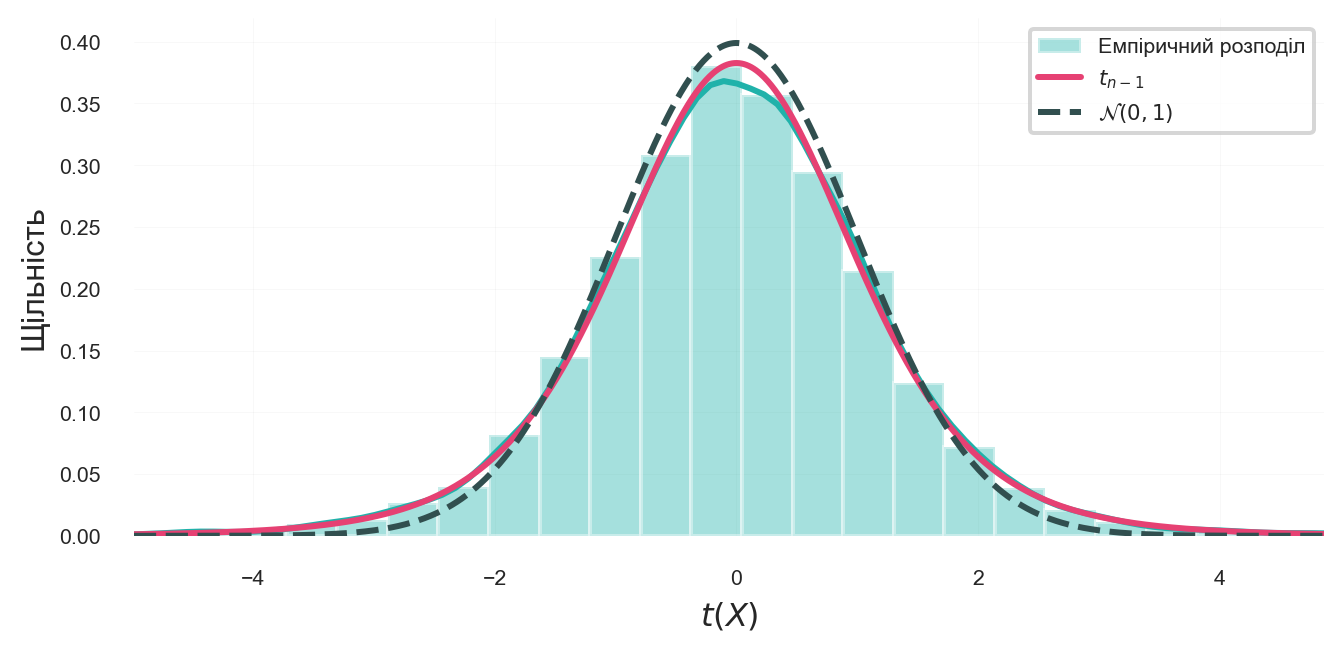
Розподіл Стьюдента практично ідеально описує дані, тоді як нормальний розподіл більш “центрований”.
Тепер, як викликати вбудований \(t\)-тест у Python? Для цього скористаємося функцією scipy.stats.ttest_1samp. Вона приймає на вхід:
a — вибірка;popmean — середнє значення генеральної сукупності, яке ми хочемо перевірити;axis — вздовж якої осі обчислювати тест. За замовчуванням 0;nan_policy — як обробляти NaN. Може приймати значення propagate, raise, omit. За замовчуванням propagate;alternative — альтернативна гіпотеза. Може приймати значення two-sided, less, greater. За замовчуванням two-sided.
meeting_time = np.array([50, 55, 70, 45, 40, 70, 80])

ttest_result = ttest_1samp(meeting_time, 70, alternative='less')
print(f"Статистика: {ttest_result.statistic:.2f}")
print(f"p-значення: {ttest_result.pvalue:.2f}")
Статистика: -2.03
p-значення: 0.04
Оскільки \(p\)-значення менше 0.05, то ми відхиляємо нульову гіпотезу. Це означає, що середня тривалість нарад у новому форматі триває менше 70 хвилин. Відповідно до \(t\)-тесту, ми можемо стверджувати, що новий формат нарад дійсно скорочує їх тривалість.
Давайте тепер розглянемо, як можна оцінити параметри генеральної сукупності за допомогою \(t\)-тесту. Розглянемо два виведення довірчого інтервалу.
Нехай є статистика \(Q\) та критерій \(\psi(Q)\) для перевірки гіпотези \(H_0: \theta = m\) рівня значущості \(\alpha\).
Тоді довірчий інтервал для \(\theta\) рівня довіри \(1 - \alpha\): множина таких \(m\), що критерій \(\psi(Q)\) не відкидає для них \(H_0\).
Нехай \(\mu\) — істинне середнє вибірки. Ми також знаємо, що за \(H_0: \sqrt{n}\dfrac{\overline X - m}{\sqrt{S^2}} \sim t_{n - 1}\).
Нас цікавлять такі \(m\), що: \(\left\{-t_{n-1, 1 - \frac{\alpha}{2}} < \sqrt{n}\dfrac{\overline X - m}{\sqrt{S^2}} < t_{n-1, 1 - \frac{\alpha}{2}} \right\}\), у цьому разі критерій не відкинеться.
Розпишемо, щоб у центрі залишилося тільки \(m\): \(\left\{\overline X - \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}} < m < \overline X + \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}}\right\}\). А отже, наш довірчий інтервал:
\[ CI_{\mu} = \left(\overline X \pm \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}} \right), \tag{4.8}\] де \(S^2 = \dfrac{1}{n - 1}\underset{i=1}{\overset{n}{\sum}}(X_i - \overline X)^2\)
Довірчим інтервалом для параметра \(\theta\) рівня довіри \(1 - \alpha\) є пара статистик \(L(X), R(X)\), таких, що \(P(L(X) < \theta < R(X)) = 1 - \alpha\).
Це класичне визначення довірчого інтервалу. Тобто, ми повинні знайти такі \(L(X)\) та \(R(X)\), що \(P(L(X) < \mu < R(X)) = 1 - \alpha\).
\[ \begin{aligned} &t(X) = \sqrt{n}\dfrac{\overline X - \mu}{\sqrt{S^2}} \sim t_{n - 1} \Rightarrow \\ &P\left(-t_{n - 1, 1-\alpha/2} < \sqrt{n}\dfrac{\overline X - \mu}{\sqrt{S^2}} < t_{n - 1, 1-\alpha/2} \right) = 1 - \alpha \Leftrightarrow \\ &P\left(\overline X - \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}} < \mu < \overline X + \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}} \right) = 1 - \alpha \end{aligned} \tag{4.9}\]
Тоді
\[ CI_{\mu} = \left(\overline X \pm \dfrac{t_{n - 1, 1 - \alpha/2} \sqrt{S^2}}{\sqrt{n}} \right) \tag{4.10}\]
Цей довірчий інтервал збігається з попереднім. Тобто, ми можемо використовувати обидва методи для побудови довірчого інтервалу.
Давайте тепер побудуємо довірчий інтервал для середнього значення тривалості нарад у новому форматі. Для цього скористаємося функцією scipy.stats.t.interval. Вона приймає на вхід:
confidence — рівень значущості;df — кількість ступенів свободи;loc — середнє значення, за замовчуванням 0;scale — стандартна девіація, за замовчуванням 1.Для побудови лівостороннього довірчого інтервалу візьмемо confidence на рівні 90%, оскільки ми хочемо перевірити, чи тривалість нарад у новому форматі менша 70 хвилин.
meeting_time = np.array([50, 55, 70, 45, 40, 70, 80])

1confidence = 0.90
2df = len(meeting_time) - 1
3loc = np.mean(meeting_time)
4scale = np.std(meeting_time, ddof=1) / np.sqrt(len(meeting_time))

5interval = t.interval(confidence, df, loc, scale)
print(f"Довірчий інтервал: {np.round(interval, 2)}")scipy.stats.t.interval.
Довірчий інтервал: [47.61 69.53]
Ми навчилися розв’язувати задачу оцінки середнього вибірки, коли дисперсія невідома, але вибірка з нормального розподілу. Тепер розглянемо, що буде, якщо вибірка не з нормального розподілу.
Приклад 4.2
Ви запускаєте онлайн-платформу з курсами програмування. Ви плануєте надавати доступ до курсів за фіксовану плату, але також інвестуєте в маркетинг та підтримку студентів. У середньому, прибуток від одного користувача (після вирахування витрат на платформу, рекламу тощо) становить \(X\) грн., але витрати на залучення кожного нового студента — 1000 грн.
Студенти можуть скористатися гарантією повернення грошей протягом 14 днів. Ви хочете перевірити, чи є прибуток від нових користувачів більшим за 0 грн. (тобто, чи є прибуток від нових користувачів більшим за витрати на залучення нових студентів). Тому іноді прибуток від користувача — позитивне число, а іноді — негативне.
Інвестори готові профінансувати вашу платформу, якщо ви доведете, що вона буде прибутковою. У вас є дані про чистий прибуток або збиток від кожного користувача, який вже зареєструвався.
Згенеруємо штучні дані для цієї задачі. Для цього змішаємо логнормальний розподіл для позитивних значень (прибуток) та від’ємний \(\chi^2\) для від’ємних значень (збиток).
n = 5000
p_positive = 0.6

n_pos = int(n * p_positive)
profits = np.random.lognormal(mean=2, sigma=0.8, size=n_pos) * 100

n_neg = n - n_pos
losses = -np.random.chisquare(df=2, size=n_neg) * 100

profits = np.concatenate([profits, losses])
np.random.shuffle(profits)

sns.histplot(profits, bins=100, kde=True, color=turquoise)

plt.xlabel('Прибуток або збиток')
plt.ylabel('Кількість користувачів')
plt.grid(True)
plt.show()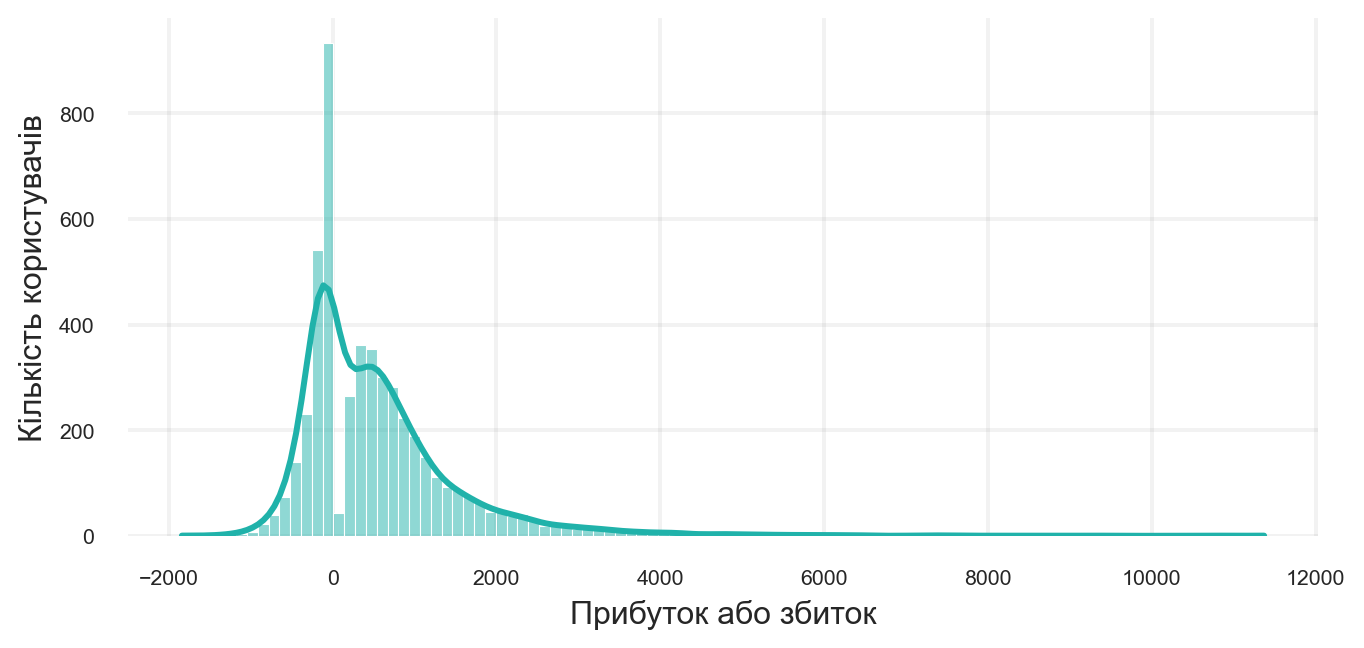
Порахуємо середній прибуток.
print(f"Середній прибуток: {profits.mean():.2f}")Середній прибуток: 547.45
На відміну від попереднього завдання тут 2 відмінності:
Згадаймо, що в нас від початку була ідея в \(Z\)-тесті замість статистики \(Z\), у якій дисперсія відома, використовувати критерій \(t\), де дисперсія оцінена на даних. І використовувати нормальний розподіл. Тільки в першому завданні цей критерій нам не допоміг. Але що, якби вибірка була великою? Чи могли б ми використовувати нормальний розподіл для наближення?
Отже, якщо вибірка велика, то ми можемо вважати, що \(t(X) \overset{H_0}{\sim} \mathcal{N}(0, 1)\).
Зауважимо, що у випадку “нормальний розподіл, велика вибірка” працюють одразу 2 критерії: \(t\)-тест та \(t'\)-тест. Це означає, що якщо \(t(X) \overset{H_0}{\sim} t_{n - 1}\) та \(t(X) \overset{H_0}{\sim} \mathcal{N}(0, 1)\), то \(t_{n - 1} \approx \mathcal{N}(0, 1)\).
Формально ж, якщо ступінь свободи в \(t\)-розподілі дорівнює нескінченності, то це нормальний розподіл! \(\lim_{n\rightarrow \infty}t_{n} = \mathcal{N}(0, 1)\)
А якщо \(t_{n - 1} \approx \mathcal{N}(0, 1)\), то ми замість \(t'\)-критерію ми можемо використовувати \(t\)-критерій!
В такому випадку критерій \(t\)-тесту буде виглядати так:
\[ H_0: \mu =\mu_0\ проти\ H_1: \mu > \mu_0 \tag{4.11}\]
Статистика \(t(X)\) буде виглядати так:
\[ t(X) = \sqrt{n}\dfrac{\overline X - \mu_0}{\sqrt{S^2}} \tag{4.12}\]
При достатньо великій вибірці \(t(X) \sim \mathcal{N}(0, 1)\).
Тоді односторонній критерій набуває вигляду:
\[ \left\{t(X) \geq z_{1 - \alpha} \right\} \tag{4.13}\]
А \(p\)-значення для одностороннього критерію можна обчислити так:
\[ p\text{-значення} = 1 - \Phi(z), \tag{4.14}\] де \(z\) — реалізація статистики \(t(X)\), \(\Phi(z)\) — функція розподілу \(\mathcal{N}(0, 1)\).
Двосторонній критерій буде виглядати так:
\[ \left\{t(X) \geq z_{1 - \frac{\alpha}{2}} \right\} \bigcup \left\{t(X) \leq -z_{1 - \frac{\alpha}{2}} \right\} \tag{4.15}\]
При цьому \(p\)-значення для двостороннього критерію можна обчислити так:
\[ p\text{-значення} = 2\cdot \min \left[{\Phi(z), 1 - \Phi(z)} \right], \tag{4.16}\] де \(z\) — реалізація статистики \(t(X)\), \(\Phi(z)\) — функція розподілу \(\mathcal{N}(0, 1)\).
Перевіримо наш критерій на великій вибірці. Для цього згеренуємо вибірку з експоненційного розподілу \(\mathcal{E}(300)\), де \(X \sim \mathcal{E}(\lambda)\), \(\lambda = 1/\mu\). Вибірка буде згенерована з параметром \(\lambda = 1/300\). Тобто, середнє значення вибірки буде \(300\).
sample_size = 2000
M = 10_000
sample_distr = expon(loc=5, scale=300)

T_X = lambda x: (
    np.sqrt(sample_size) * (np.mean(x) - sample_distr.mean()) /
    np.std(x, ddof=1)
)

T_sample = sample_statistics(
    number_of_experiments=M,
    statistic_function=T_X,
    sample_size=sample_size,
    sample_distr=sample_distr
)

l, r = np.quantile(T_sample, [0.001, 0.999])
x = np.linspace(l, r, 1000)

sns.distplot(T_sample, label='Емпіричний розподіл', color=turquoise)
plt.plot(x, norm(0, 1).pdf(x),
         label='$\mathcal{N}(0, 1)$', color=red_pink)

plt.legend()
plt.xlabel('$T(X)$')
plt.ylabel('Щільність')
plt.xlim(l, r)
plt.grid(linewidth=0.2)
plt.show()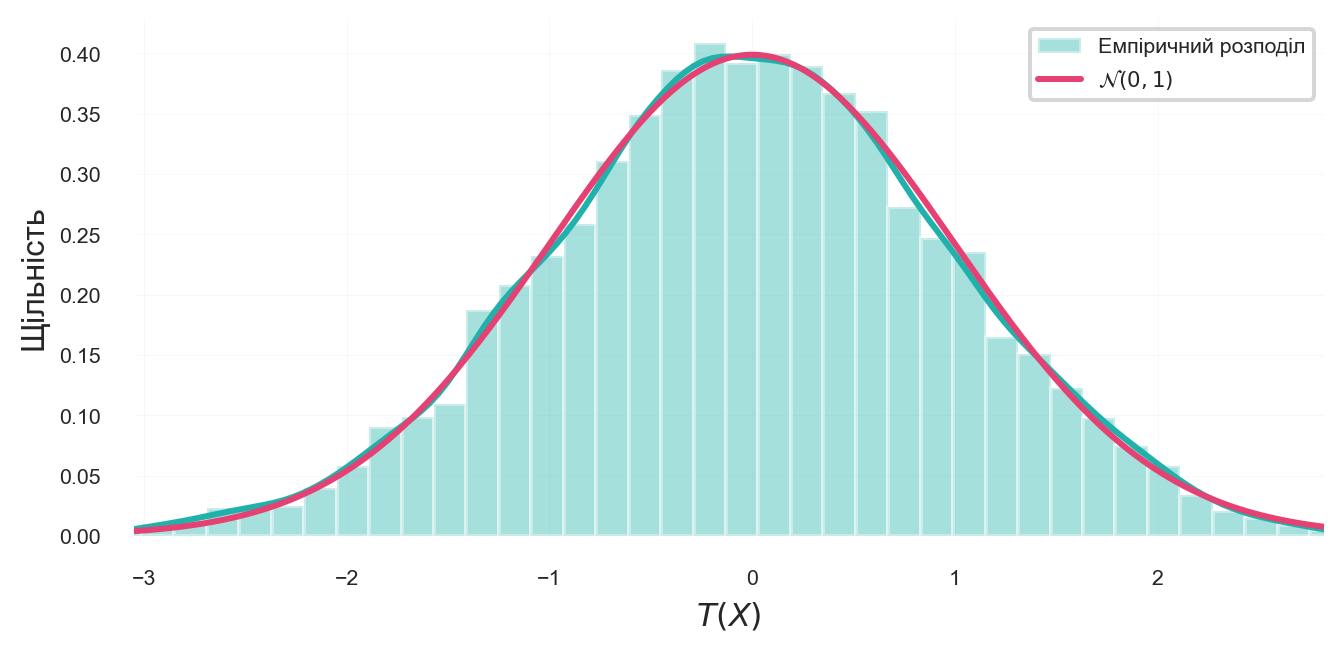
Ми бачимо, що емпіричний розподіл \(t'(X)\) та теоретичний \(\mathcal{N}(0, 1)\) збігаються. Це означає, що ми можемо використовувати \(t'\)-тест для перевірки гіпотези. Якщо ж перевірити на великих вибірках з нормального розподілу, то \(t\)-тест та \(t'\)-тест будуть давати доволі схожі результати.
sample_size = 2000
M = 30_000
sample_distr = norm(loc=5, scale=300)

T_X = lambda x: (
    np.sqrt(sample_size) * (np.mean(x) - sample_distr.mean()) /
    np.std(x, ddof=1)
)

T_sample = sample_statistics(
    number_of_experiments=M,
    statistic_function=T_X,
    sample_size=sample_size,
    sample_distr=sample_distr
)

l, r = np.quantile(T_sample, [0.001, 0.999])
x = np.linspace(l, r, 1000)

sns.distplot(T_sample, label='Емпіричний розподіл', color=turquoise)
plt.plot(x, norm(0, 1).pdf(x),
         label='$\mathcal{N}(0, 1)$', color=red_pink)

plt.legend()
plt.xlabel('$T(X)$')
plt.ylabel('Щільність')
plt.xlim(l, r)
plt.grid(linewidth=0.2)
plt.show()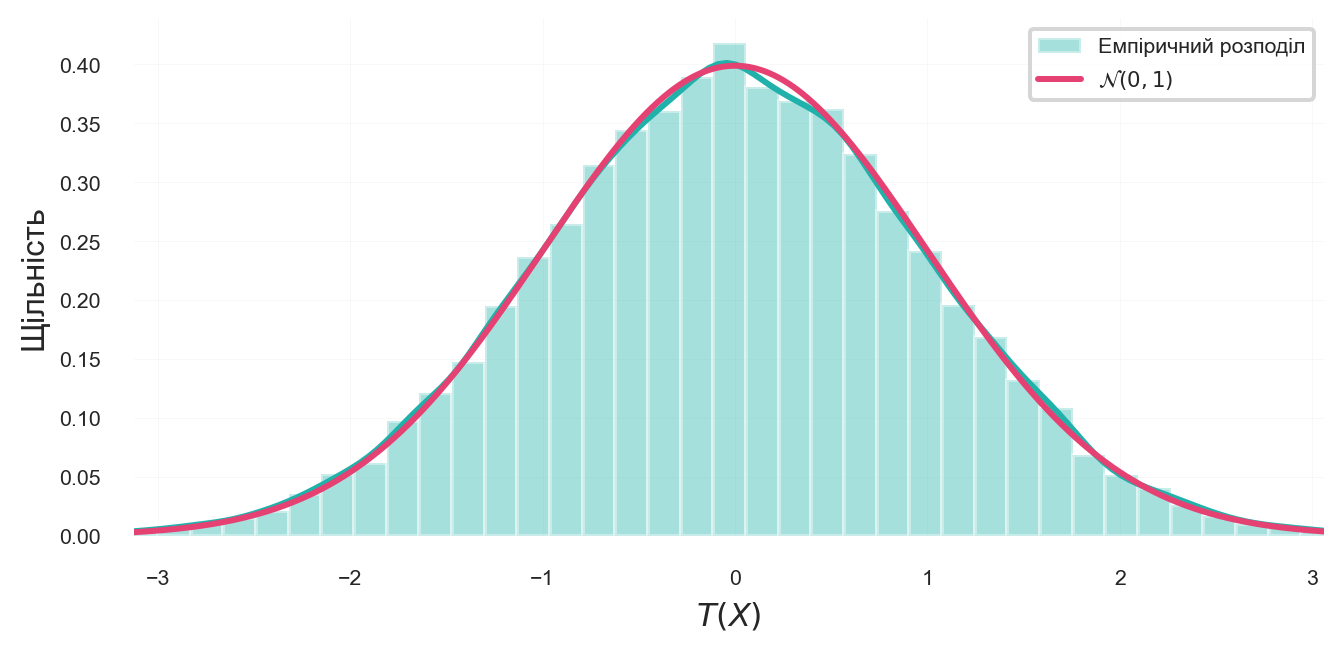
Виходить, що статистика \(t'(X)\) при великій вибірці з нормального розподілу також буде з нормального розподілу.
Довірчий інтревал виводиться аналогічно до \(t\)-тесту.
\[ \begin{aligned} &t'(X) = \sqrt{n}\dfrac{\overline X - \mu}{\sqrt{S^2}} \sim \mathcal{N}(0, 1) \Rightarrow \\ &P\left(-z_{1 - \frac{\alpha}{2}} < \sqrt{n}\dfrac{\overline X - \mu}{\sqrt{S^2}} < z_{1 - \frac{\alpha}{2}} \right) = 1 - \alpha \Leftrightarrow \\ &P\left(\overline X - \dfrac{z_{1 - \frac{\alpha}{2}} S^2}{\sqrt{n}} < \mu < \overline X + \dfrac{z_{1 - \frac{\alpha}{2}} S^2}{\sqrt{n}} \right) = 1 - \alpha \end{aligned} \tag{4.17}\]
Переглнемо на практиці, як це виглядає у Python.
sample = expon(scale=300).rvs(2000)
ci = norm.interval(confidence=0.95, loc=np.mean(sample), scale=sem(sample))
print(f"CI = {np.round(ci, 2)}")
CI = [293.89 319.75]
Тепер ми можемо повернутися до нашої задачі з прибутком.
ci_profit = norm.interval(confidence=0.95, loc=np.mean(profits), scale=sem(profits))
print(f"CI = {np.round(ci_profit, 2)}")
CI = [520.19 574.72]
Це означає, що ми можемо стверджувати, що прибуток від нових користувачів більший за 0 грн.
Для початку визначимося, коли який критерій краще використовувати?
df = 59
t_dist = t(df=df)
z_dist = norm(loc=0, scale=1)

x = np.linspace(-3, 3, 100)

fig, ax = plt.subplots(figsize=(8, 2.5))
plt.plot(x, z_dist.pdf(x), label='$\mathcal{N}(0, 1)$', color=red_pink)
plt.plot(x, t_dist.pdf(x), label='$t_{59}$', color=turquoise)
plt.legend()
plt.grid(linewidth=0.2)
plt.show()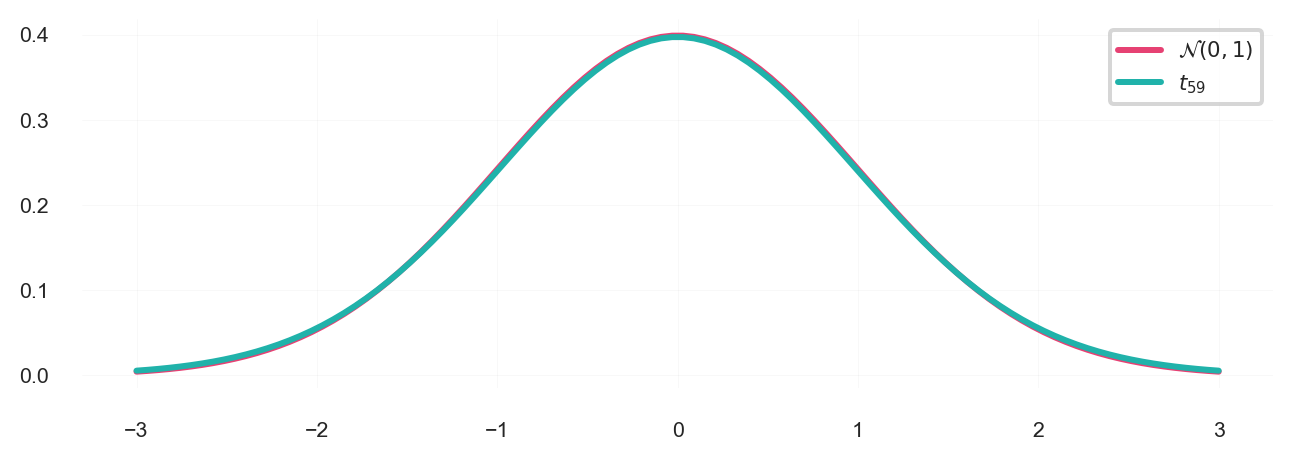
pvalue < alpha. У \(t\)-тест \(p\)-значення \(\geq\) \(t'\)-тест \(p\)-значення.pvalue = t_distr.cdf(x) або pvalue = norm_dist.cdf(x). Тож чим важчий хвіст у розподілу, тим більше \(p\)-значення.Подивимось на прикладі.
df_array = [2, 5, 10, 20]
x = np.linspace(-3, 3, 100)

for df in df_array:
    t_dist = t(df=df)
    plt.plot(x, t_dist.cdf(x), label=f't(df={df})')

z_dist = norm(loc=0, scale=1)
plt.plot(x, z_dist.cdf(x), c=red_pink, label='$\mathcal{N}(0, 1)$')
plt.legend()
plt.xlabel('X')
plt.grid(linewidth=0.2)
plt.show()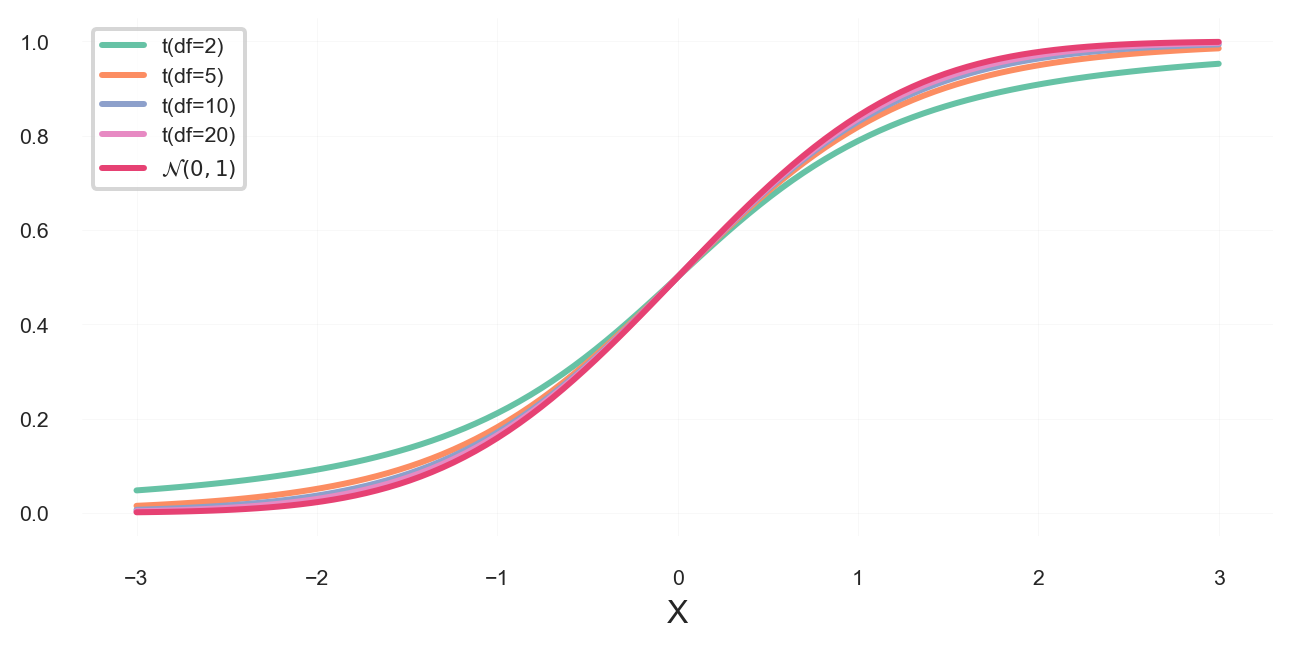
Як видно на графіку, що менший ступінь свободи, то вищою є лінія на графіку (за x < 0), а отже \(P(X < x)\) буде більшим, ніж у нормальному розподілі. Тобто, \(t\)-тест буде давати менше \(p\)-значення, ніж \(t'\)-тест. А отже, \(t\)-тест буде відкидати нульову гіпотезу частіше, ніж \(t'\)-тест.
Розподіл Стьюдента з нескінченністю ступенів свободи — це нормальний розподіл: \(t_{\infty} = \mathcal{N}(0, 1)\). Тому norm(0, 1).cdf(x) = t_distr(df=infinity).cdf(x) < t_distr(df=N).cdf(x).
Тому, якщо вибірка невелика, безпечніше використовувати \(t\)-тест. Але все ще не факт, що ваш критерій буде валідний!
Ми бачимо, що ми скрізь можемо використовувати \(t\)-тест (а \(t'\)-тест не завжди), і в разі маленьких вибірок він безпечніший. Тому \(t\)-тест і став набагато популярнішим, ніж \(t'\)-тест. Але \(t'\)-тест на практиці може бути теж корисний:
Повернемося до завдання зі стартапом. Уявімо, що ми хочемо запустити наш стартап на новому ринку, наприклад у іншій країні. Питання: чи можемо ми зменшити розмір вибірки?
Що взагалі нам заважає взяти занадто маленьку вибірку? Наприклад, якщо ми перевіряємо наш стартап на 1-2 користувачів, то ми нічого не можемо сказати про наш істинний ефект, він може бути як більшим за 0, так і меншим. Буде занадто широкий довірчий інтервал (через велику дисперсію у вибірці), і нам потрібен величезний ефект, щоб його виявити.
Ще, можливо, ми не можемо використовувати критерій на такій маленькій вибірці. А якщо вибірка складалася б із нескінченної кількості користувачів, то ми могли б абсолютно точно сказати справжній прибуток від користувача, навіть якщо він дорівнює 1 копійці. При цьому обидва випадки нас не влаштовують. У першому — ми не зможемо запустити стартап через занадто великий шум, а в другому — нам потрібна вічність, щоб перевірити нашу гіпотезу.
І тут нам допоможе MDE (minimum detectable effect). Це таке істинне значення ефекту, що наш шанс його виявити дорівнює \(1-\beta\) при використанні нашого критерію.
Ми можемо подивитись, який ефект ми зможемо зафіксувати під меншої кількості користувачів, і від цього вирішити, чи підходить нам така вибірка, чи ні. Наприклад:
Тому слід чітко визначити від чого залежить MDE. Це може бути:
Тепер давайте виведемо формулу виходячи з того, що ми знаємо всі ці чотири параметри. Для початку визначимося з гіпотезою, що перевіряється:
\[ H_0: \mu_0 = 0\ проти. \ H_1: \mu_0 > 0 \tag{4.18}\]
Позначимо оцінку дисперсії середнього значення:
\[ S^2_{\mu} := \frac{S^2}{N} \tag{4.19}\]
А також стандартне відхилення середнього значення:
\[ S_{\mu} = \sqrt{\frac{S^2}{N}} \tag{4.20}\]
Тепер ми знаємо, що
\[ \overline X \sim \mathcal{N}(\mu, S^2_{\mu}) \tag{4.21}\]
Нам треба знайти \(\text{MDE}=m\), таке, що:
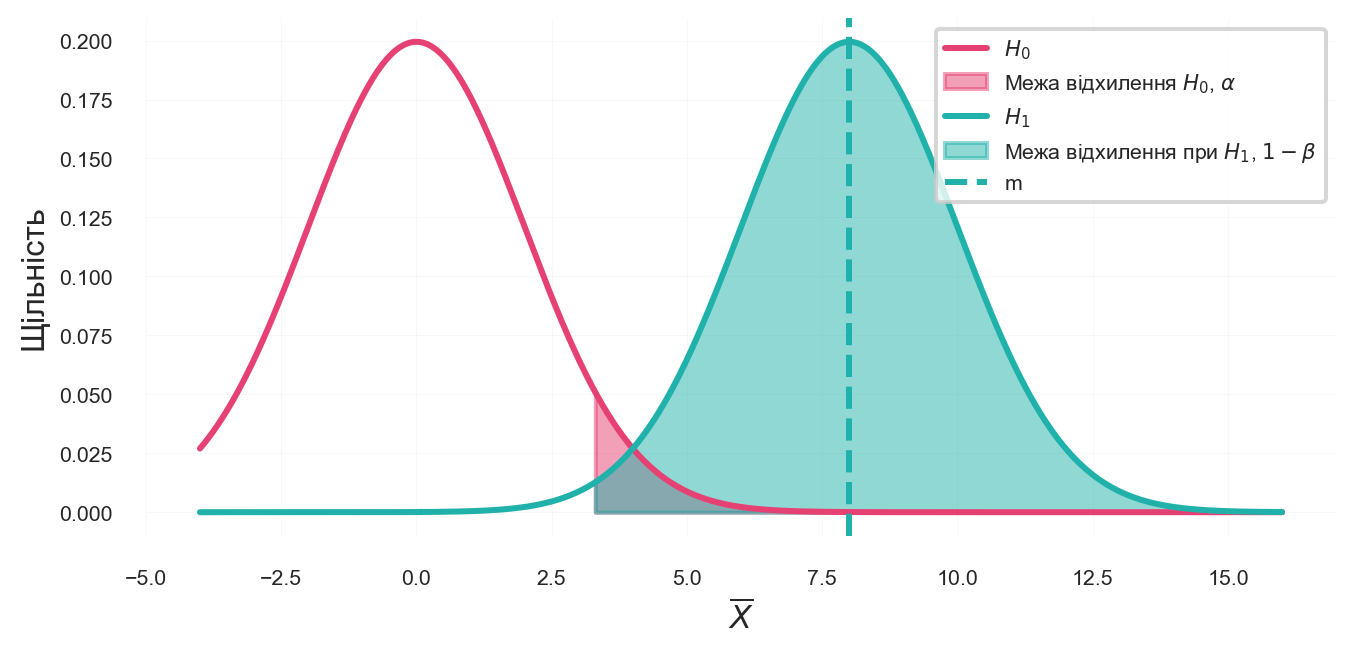
Нехай
\[ B(X): P_{H_0}(\overline X > B(X)) = \alpha, \tag{4.22}\] де \(B(X)\) — межа відхилення нульової гіпотези.
Тоді
\[ P_{H_1}(\overline X > B(X)) = 1-\beta \tag{4.23}\]
Або
\[ P_{H_1}(\overline X - m > B(X) - m) = 1-\beta \tag{4.24}\]
Позначимо \(\xi := \overline X - m\). Тоді
\[ P_{H_0}(\xi > B(X) - m) = 1-\beta, \tag{4.25}\] де \(B(X) - m\) — межа відхилення нульової гіпотези з урахуванням істинного ефекту.
Треба розв’язати ці 2 рівняння й ми отримаємо вираз \(m\) через усі чотири параметри.
За \(H_0\) наш критерій має такий вигляд:
\[ \left\{T(X) \geq z_{1 - \alpha} \right\} \Leftrightarrow \left\{\sqrt{N}\dfrac{\overline X}{\sqrt{S^2}} \geq z_{1 - \alpha} \right\} \Leftrightarrow B(X) = z_{1 - \alpha}\sqrt{\frac{S^2}{N}} = z_{1 - \alpha}S_{\mu} \tag{4.26}\]
Тоді
\[ P_{H_0}(\xi > z_{1 - \alpha}S_{\mu} - m) = 1-\beta \tag{4.27}\]
Але працювати з розподілом \(\mathcal{N}(0, S^2_{\mu})\) не дуже зручно, набагато простіше з \(\mathcal{N}(0, 1)\). Для цього переходу достатньо перейти від \(\xi \rightarrow \dfrac{\xi}{S_{\mu}}\) за властивостями нормального розподілу.
Позначимо \(\eta := \dfrac{\xi}{S_{\mu}}\). Тоді
\[ \begin{aligned} &P_{H_0}(\xi > z_{1 - \alpha}S_{\mu} - m) =\\ &P_{H_0}(\dfrac{\xi}{S_{\mu}} > \dfrac{z_{1 - \alpha}S_{\mu} - m}{S_{\mu}}) =\\ & P_{\mathcal{N}(0, 1)}(\eta > z_{1 - \alpha} - \dfrac{m}{S_{\mu}}) = 1-\beta \end{aligned} \tag{4.28}\]
За умови \(\Phi(C) = P(\eta < C)\), тоді
\[ \begin{aligned} &1 - \Phi \left(z_{1 - \alpha} - \dfrac{m}{S_{\mu}} \right) = 1-\beta \Leftrightarrow\\ &z_{1 - \alpha} - \dfrac{m}{S_{\mu}} = z_{\beta}, \end{aligned} \tag{4.29}\] де \(z_{\beta} = \Phi^{-1}(\beta)\) — квантиль \(\beta\) нормального розподілу.
Тепер згадаємо, що \(\eta \sim \mathcal{N}(0, 1)\), тоді
\[ m = (z_{1 - \alpha} - z_{\beta}) \cdot S_{\mu} = (z_{1 - \alpha} + z_{1 - \beta}) \cdot \sqrt{\frac{S^2}{N}} \tag{4.30}\]
Отже, ми отримали формулу для MDE:
\[ \text{MDE} = (z_{1 - \alpha} + z_{1 - \beta}) \cdot \sqrt{\frac{S^2}{N}} \tag{4.31}\] де \(z_{1 - \alpha}\) — квантиль \(\alpha\) нормального розподілу, \(z_{1 - \beta}\) — квантиль \(\beta\) нормального розподілу, \(S^2\) — оцінка дисперсії, \(N\) — розмір вибірки.
Повернемося до стартапу. Припустимо, що \(N = 1000\), \(\alpha=5\)%, \(1-\beta=80\)%, а як дізнатися \(S^2\)?
На практиці є 3 способи:
Подивимося тепер MDE у нашому завданні.
N = 1000
S2 = np.var(profits)
alpha = 0.05
beta = 1 - 0.8

MDE = (norm().ppf(1-alpha) + norm().ppf(1 - beta)) * np.sqrt(S2/N)
print(f"MDE при N = {N}: {np.round(MDE, 2)}")
MDE при N = 1000: 77.33
А отже, ми можемо розраховувати на точність лише в 77.33 грн. Але дня нас це може бути занадто великий MDE: хочеться, щоб він був \(\leq\) 50 грн, ми припускаємо, що це ймовірніший істинний ефект, виходячи з поперелднього досвіду.
Давайте тепер розв’яжемо зворотну задачу: Ми знаємо \(MDE=50\) грн., \(\alpha=5\)%, \(1-\beta=80\)%, \(S^2\), чому дорівнює \(N\)? Виведемо його з формули MDE:
\[ N = \left(\dfrac{z_{1 - \alpha} + z_{1 - \beta}}{\text{MDE}}\right)^2 S^2 \tag{4.32}\]
S2 = np.var(profits)
alpha = 0.05
beta = 1 - 0.8
mde = 50

N = ((norm().ppf(1-alpha) + norm().ppf(1 - beta)) / mde)**2 * S2
N = int(N) + 1
print(f"Мінімальний розмір вибірки: {N}")
Мінімальний розмір вибірки: 2392
Тепер ми знаємо, що нам потрібно 2392 користувачів, щоб перевірити нашу гіпотезу з MDE 50 грн.
Приклад 4.3
На нашому онлайн-сервісі з розміщення оголошень є платні послуги просування. Ми плануємо запровадити знижки на ці послуги, щоб залучити більше користувачів і збільшити дохід. Для перевірки ефективності було вирішено провести A/B тест: одній половині нових користувачів ми не надавали знижки, а другій половині — надавали знижки на просування. Потрібно визначити, чи призвело це до зростання доходу.
Для вирішення цього завдання ми не можемо використовувати одновибірковий \(t\)-тест. Цього разу в нас дві вибірки \(A\) — контроль, та \(B\) — тест.
Наша гіпотеза звучить так:
\[ H_0: E A = E B \; проти \; H_1: E A < E B \]
Далі в нас може бути кілька варіантів:
Тоді у випадку рівних дисперсій \(\sigma^2_A = \sigma^2_B\), спільна дисперсія \(S^2_{pooled}\) обчислюється за формулою:
\[ S^2_{pooled} = \dfrac{(N - 1)S^2_A + (M - 1)S^2_B}{N + M - 2}, \tag{4.33}\] де \(N\), \(M\) — розмір контролю і тесту відповідно.
А критерій має такий вигляд:
\[ t(A, B) = \dfrac{\overline A - \overline B}{S^2_{pooled}\sqrt{1/N + 1/M}} \overset{H_0}{\sim} t_{n + m - 2} \tag{4.34}\] де \(n + m - 2\) — ступені свободи.
У випадку, якщо дисперсії не рівні \(\sigma^2_A \neq \sigma^2_B\)5, то:
\[ t(A, B) = \dfrac{\overline A - \overline B}{\sqrt{S^2_{A}/N + S^2_{B}/M}} \overset{H_0}{\sim} t_{v} \tag{4.35}\] де \(v\) — ступені свободи, які обчислюються за формулою:
\[ v = \frac{\left(\frac{S^2_{A}}{N} + \frac{S^2_{B}}{M} \right)^2}{\left(\frac{(S^2_{A})^2}{N^2(N - 1)} + \frac{(S^2_{B})^2}{M^2(M-1)} \right)} \tag{4.36}\]
Тоді ми можемо використовувати нормальну апроксимація при великій вибірці:
\[ t(A, B) = \dfrac{\overline A - \overline B}{\sqrt{S^2_{A}/N + S^2_{B}/M}} \overset{H_0}{\sim} \mathcal{N}(0, 1) \tag{4.37}\] де \(S^2_{A}\), \(S^2_{B}\) — вибіркові дисперсії.
Для реалізації двовибіркового \(t\)-тесту в Python ми можемо використовувати ttest_ind6 з бібліотеки scipy.stats (SciPy community (2023)).
Подивимось на приклад з двома вибірками, перша вибірка — з експоненційного розподілу, а друга — з нормального розподілу.
X = expon(scale=1100).rvs(1000)
Y = norm(loc=980, scale=30).rvs(1000)

t_results = ttest_ind(X, Y, equal_var=False, alternative='greater')
ci_t_results = t_results.confidence_interval(confidence_level=0.95)

print(f"t-статистика = {np.round(t_results.statistic, 2)}")
print(f"p-значення = {np.round(t_results.pvalue, 5)}")
print(f"Довірчий інтервал = {np.round(ci_t_results, 2)}")
t-статистика = 3.62
p-значення = 0.00015
Довірчий інтервал = [68.38 inf]
При використанні \(t\)-тесту, як одновибіркового, так і двовибіркового, важливо пам’ятати, що:
Загальні питання та Мотивація
\(t\)-статистика та \(t\)-розподіл
Застосування \(t\)-тесту
scipy.stats використовують для проведення одновибіркового \(t\)-тесту? Які основні параметри вона приймає?Довірчі інтервали
scipy.stats можна використати для побудови довірчого інтервалу на основі \(t\)-розподілу?Припущення \(t\)-тесту та великі вибірки
Мінімально виявлений ефект (MDE)
Двовибірковий \(t\)-тест
scipy.stats використовується для проведення двовибіркового \(t\)-тесту?\(t\)-критерій Стьюдента є одним із найбільш уживаних статистичних інструментів. Для глибокого розуміння його теорії та застосування зверніться до:
scipy.stats). Офіційна документація є незамінним довідником для практичного застосування функцій ttest_1samp та ttest_ind, розуміння їхніх параметрів та результатів.Розподіл \(\chi^2\) — це розподіл суми квадратів \(k\) незалежних нормальних випадкових величин з нульовим математичним сподіванням. Тобто, якщо \(X_1, X_2, \ldots, X_k \sim \mathcal{N}(0, 1)\), то \(Y = X_1^2 + X_2^2 + \ldots + X_k^2 \sim \chi^2_k\).↩︎
Розподіл Стьюдента — це розподіл, який виникає при нормальному розподілі з невідомою дисперсією. Якщо \(X_1, X_2, \ldots, X_n \sim \mathcal{N}(\mu, \sigma^2)\), то \(t = \dfrac{\overline{X} - \mu}{S/\sqrt{n}} \sim t_{n-1}\), де \(\overline{X}\) — вибіркове середнє, \(S\) — вибіркова стандартна девіація.↩︎
Такий підхід називається \(t\)-тестом Уелча (Welch (1947)).↩︎
Документація: https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.ttest_ind.htm↩︎